Agent 评测
从检索排序指标、工具与轨迹评测,到数据集构建、离线与端到端测试、统计检验、Baseline 和回归门禁。
目录 · 43 节
- 1. 先定义评测对象
- 2. 检索指标的统一记号
- 3. Precision@K、Recall@K 与 Hit Rate@K
- Macro与Micro平均
- 4. Reciprocal Rank与MRR
- 5. Average Precision与MAP
- 6. DCG与NDCG
- 6.1 看任务选指标
- 7. 指标实现伪代码
- 8. Context与生成指标
- 8.1 Context Precision与Recall
- 8.2 Faithfulness
- 8.3 Citation Precision与Recall
- 8.4 Answer Correctness
- 8.5 拒答与选择性风险
- 9. Tool评测
- 9.1 分类指标
- 9.2 参数准确性
- 10. Trajectory评测
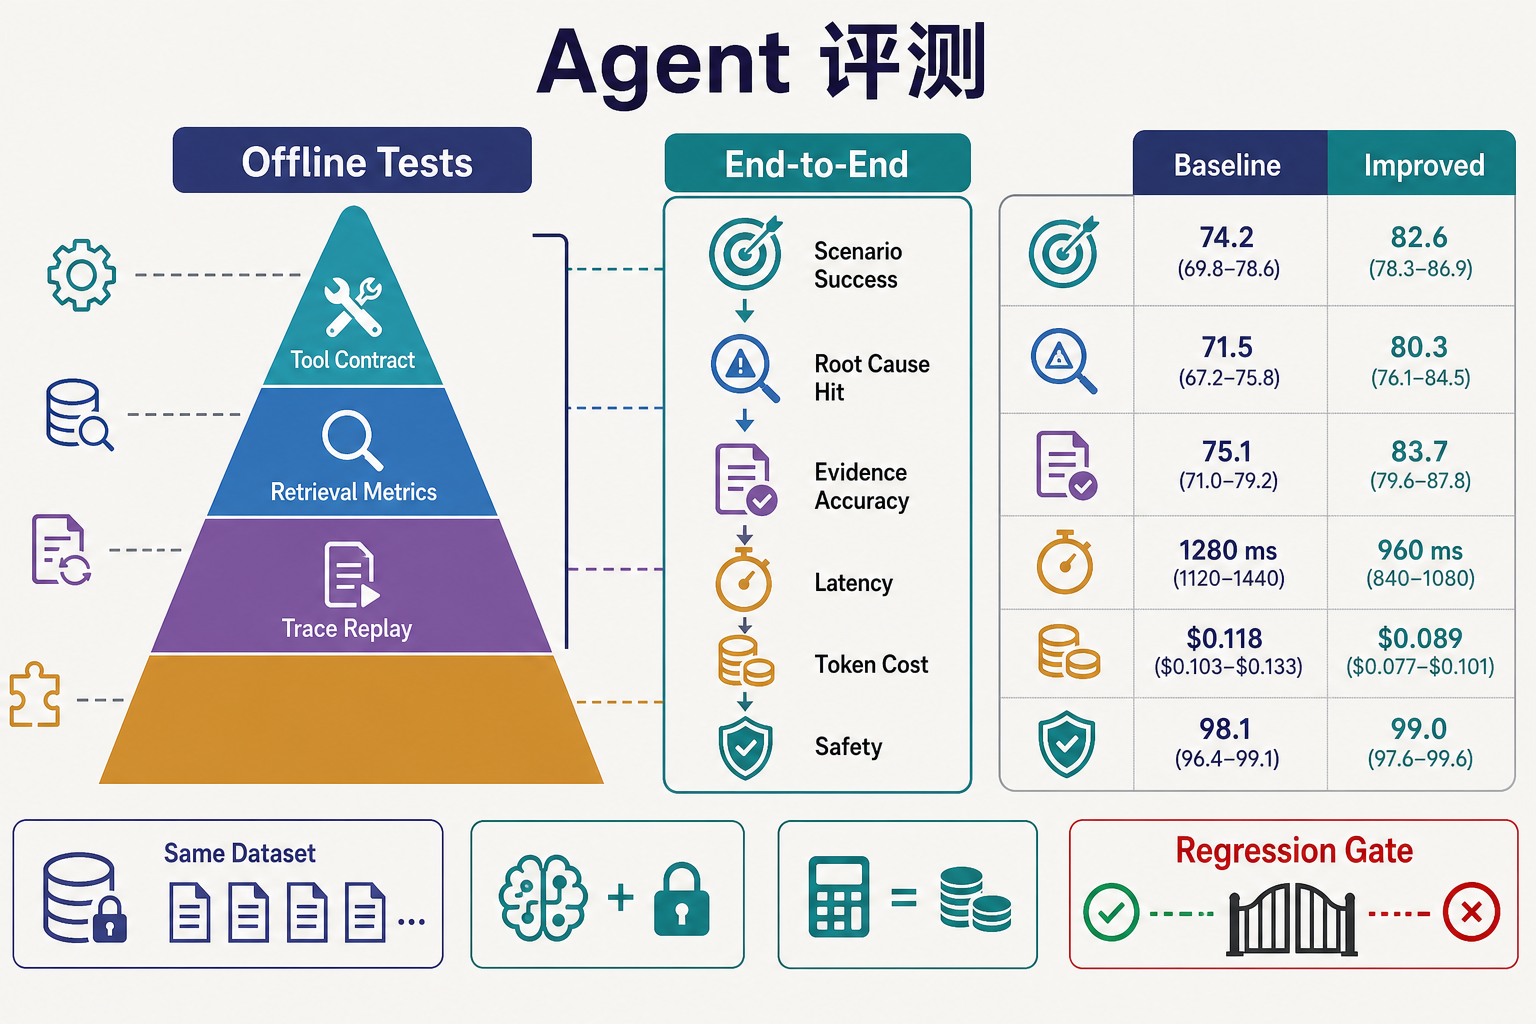
- 11. 离线测试与端到端测试
- 11.1 离线测试
- 11.2 端到端测试
- 12. 评测集构建
- 12.1 数据来源
- 12.2 标注
- 12.3 Hard Negative
- 12.4 切分与泄漏
- 13. Baseline实验
- 13.1 控制变量
- 13.2 随机性与重复运行
- 14. 置信区间与显著性
- 14.1 Paired Bootstrap
- 14.2 二元成功率
- 15. 回归门禁
- 16. LLM-as-a-Judge
- 17. RAG评测的技术栈表述
- 技术栈一行版
- 与检索技术栈合并
- 项目描述版
- 面试口述版
- 如果技术栈栏空间很短
- 18. 项目回答
- 19. 高频追问
Agent 评测
Agent评测需要回答三个问题:组件是否正确,完整任务是否成功,改进方案是否在可接受的成本和风险下产生了稳定收益。只展示若干成功Case,不能说明系统质量,也不能定位失败来源。
1. 先定义评测对象
同一个Agent至少包含五层可评测对象:
| 层级 | 输入 | 输出 | 典型指标 |
|---|---|---|---|
| Retrieval | Query、知识快照 | 候选证据 | Recall@K、MRR、MAP、NDCG |
| Tool | Tool Schema、参数 | Observation / Error | 选择准确率、参数准确率、成功率 |
| Trajectory | State、可用工具 | Action序列 | 路径成功率、冗余步骤、预算违规 |
| Answer | Evidence、任务 | 最终回答 | Correctness、Faithfulness、Citation |
| System | 完整场景 | 状态与副作用 | Task Success、延迟、成本、安全 |
指标必须与任务契约一致。检索系统的Gold是文档、Chunk还是事实集合,会直接改变Recall的分母;Agent任务允许多条合法路径时,也不能用唯一轨迹做严格字符串匹配。
2. 检索指标的统一记号
对查询,全文统一使用下面这组记号:
| 符号 | 含义 | 示例 |
|---|---|---|
| Query 的Gold相关结果集合 | ||
| 系统返回的前个有序结果 | ||
| 第名是否相关,取0或1 | 第2名A相关,则 | |
| 第名的分级相关性 | 0无关、1背景、2部分支持、3直接支持 | |
| 整个评测Query集合 | ||
| 只观察排序结果的前名 | Recall@5中的 |
先固定相关性单位。例如一个答案必须同时依赖“错误日志”和“配置定义”时,两个Evidence都应进入G_q;若只标其中一项,系统漏掉另一项也不会被扣分。
3. Precision@K、Recall@K 与 Hit Rate@K
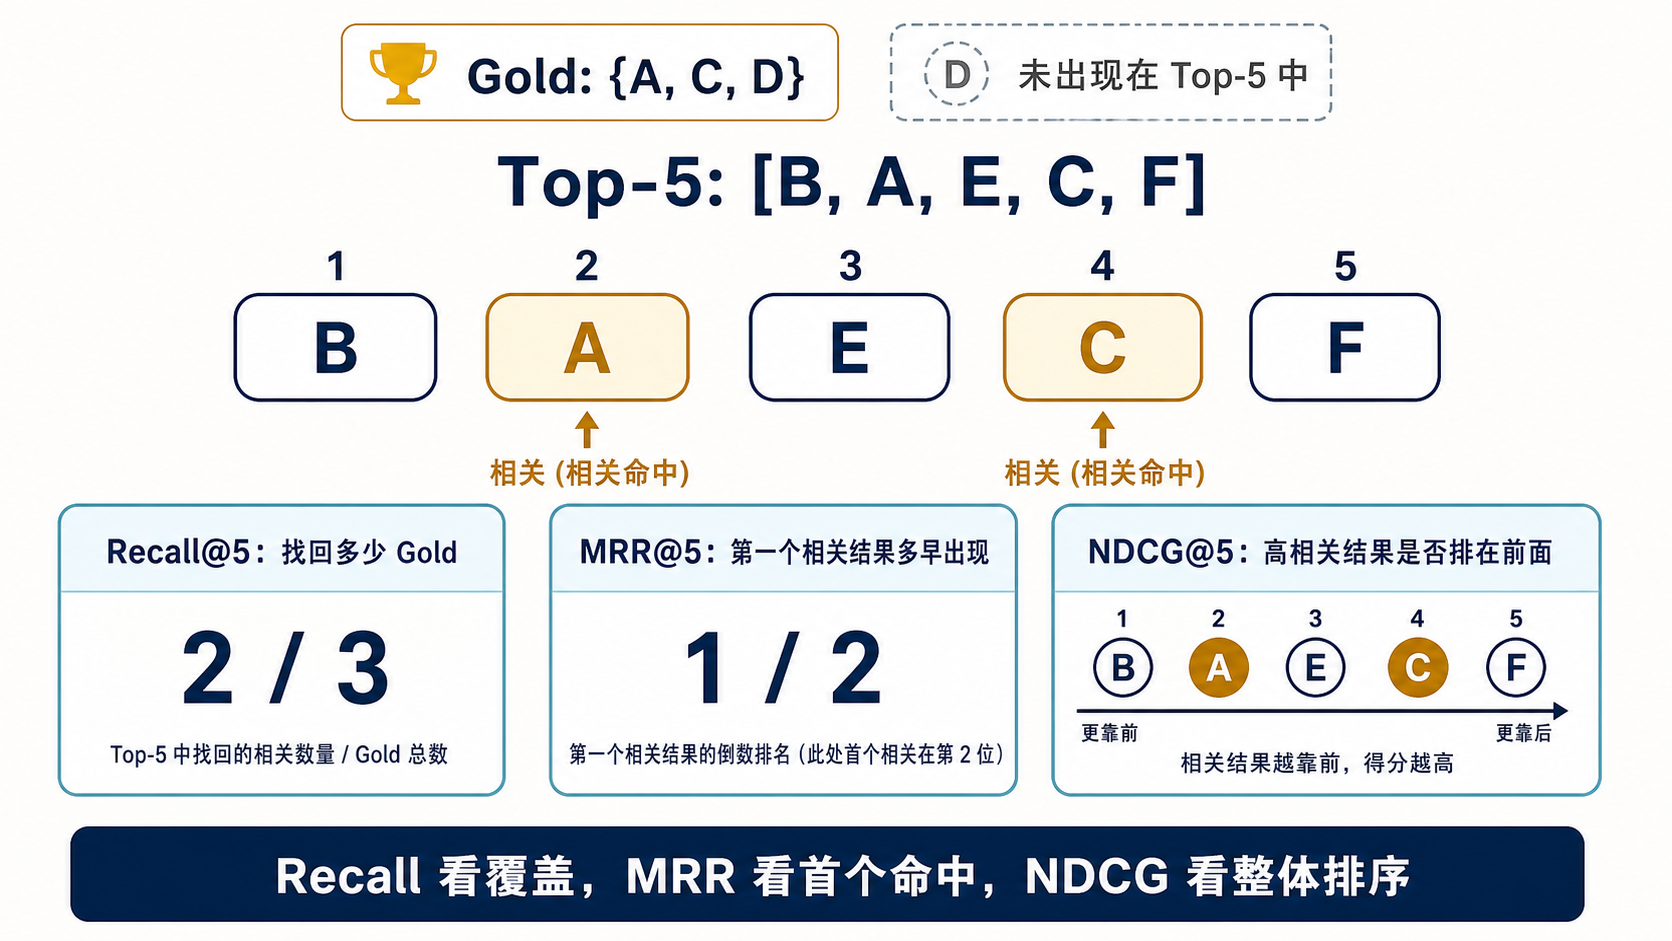
假设Gold为{A,C,D},Top-5为[B,A,E,C,F]:
Precision关心返回结果中有多少相关;Recall关心Gold被找回多少;Hit Rate只关心至少命中一个。对需要多份证据的问题,Hit Rate信息过少。
Macro与Micro平均
Macro让每个Query权重相同;Micro让Gold数量多的Query权重更大。应根据业务目标选择,并同时报告样本分布,避免一个平均数掩盖长尾。
4. Reciprocal Rank与MRR
令rank_q为第一个相关结果的排名:
手算:
| Query | Gold数量 | Top-5命中排名 | Recall@5 | RR@5 |
|---|---|---|---|---|
| Q1 | 2 | 1、4 | 1.0 | 1.0 |
| Q2 | 1 | 3 | 1.0 | 1/3 |
| Q3 | 2 | 2,仅命中一篇 | 0.5 | 1/2 |
| Q4 | 1 | 无 | 0 | 0 |
MRR只使用第一个相关结果。第1名相关、第2至第5名全部错误,与第1至第5名全部相关,RR都等于1。因此MRR适合“尽快给出第一个正确结果”,不适合单独评估多证据覆盖。
5. Average Precision与MAP
Average Precision同时考虑多个相关结果的位置。设前i个结果的Precision为P@i:
有些实现使用|G_q|作为分母,即使Gold数量大于K;必须在报告中写明定义。
例:Gold为{A,C,D},Top-5为[A,B,C,E,D]:
若把三个相关结果改排到[B,E,A,C,D],Recall@5仍为1,但AP下降,因为正确结果出现得更晚。
6. DCG与NDCG
NDCG支持分级相关性,适合区分“直接回答问题的证据”“有帮助但不充分”“仅背景相关”。常见定义为:
其中是将同一组Gain按降序排列后得到的最大DCG。
若所有Gold都使用二元相关性,则gain_i为0或1。分级标签例子:
3:直接且充分支持答案;2:相关并支持部分结论;1:背景相关;0:无关。
假设Top-3 Gain为[3,1,2]:
理想排序的Gain为:
不同库也可能使用gain_i/log₂(i+1)而不是(2^gain_i-1)/...。复现实验时必须固定实现。
6.1 看任务选指标
| 评测目标 | 优先指标 | 原因 |
|---|---|---|
| Top-K里至少有没有一条可用证据 | Hit Rate@K | 只判断是否命中,不关心覆盖多少 |
| Gold证据找全了多少 | Recall@K | 分母就是全部Gold数量 |
| 第一条正确结果出现得够不够早 | MRR@K | 只看首次命中的排名 |
| 多条正确结果是否整体排在前面 | MAP@K | 每次命中都考虑此前排序精度 |
| 结果有强弱等级,强证据应更靠前 | NDCG@K | 同时考虑Gain和位置折损 |
| 最终回答是否被证据支持 | Faithfulness、Citation指标 | 检查生成结果,不只检查Retriever |
7. 指标实现伪代码
function metrics_at_k(ranked_ids, gold_ids, k):
    topk = ranked_ids[0:k]
    hits = [1 if id in gold_ids else 0 for id in topk]

    precision = sum(hits) / k
    recall = sum(hits) / size(gold_ids)
    hit_rate = 1 if sum(hits) > 0 else 0

    rr = 0
    ap_sum = 0
    seen_hits = 0

    for i in 1..k:
        if hits[i-1] == 1:
            seen_hits += 1
            if rr == 0:
                rr = 1 / i
            ap_sum += seen_hits / i

    ap = ap_sum / min(size(gold_ids), k)
    return precision, recall, hit_rate, rr, ap
实现时还要决定:重复Chunk是否去重;同一父文档的多个Chunk算一次还是多次;无Gold Query是跳过、记0还是单独进入“不可回答”集合。
8. Context与生成指标
8.1 Context Precision与Recall
如果能把最终Context拆成Evidence Unit:
它们与Retrieval指标不同:Retriever可能召回Gold,但Context Builder因Token预算将其删除;此时Retrieval Recall高,Context Recall低。
8.2 Faithfulness
把答案拆成原子Claim集合C,判断每个Claim是否由提供的Context支持:
需要单独标记不可验证的主观表达和无事实内容。Faithfulness高只表示答案忠于Context,不表示Context正确或答案完整。
8.3 Citation Precision与Recall
Citation存在不等于Citation正确。必须检查引用与Claim的蕴含关系,以及chunk_id + version_id是否对应实际展示内容。
8.4 Answer Correctness
封闭任务可使用Exact Match、Token F1或结构化字段准确率;开放RCA可按Rubric拆分:Root Cause、Evidence、Impact、Action和Uncertainty。每项单独评分,避免一段语言流畅的答案掩盖根因错误。
8.5 拒答与选择性风险
包含“无答案”样本时,需要同时衡量回答覆盖率与已回答样本的正确率:
提高拒答阈值通常会降低Coverage并提高Selective Accuracy。应绘制Risk-Coverage曲线,而不是只报告拒答率。对必须回答的任务,还要把不必要拒答计为False Negative;对高风险动作,缺少证据时拒答通常是正确行为。
9. Tool评测
Tool Call至少分四层:
- Tool Selection:是否选对工具;
- Argument Validity:是否通过Schema;
- Argument Correctness:参数值是否满足任务;
- Execution Outcome:真实执行是否成功且副作用正确。
9.1 分类指标
对某个Tool或危险动作,可构造混淆矩阵:TP、FP、FN、TN。
对危险写操作,FP意味着不该调用却调用,通常比FN更严重;此时不能只优化宏平均F1,应单独设置False Positive Rate门禁。
9.2 参数准确性
- Exact Match:适合枚举、ID、时间窗口等确定字段;
- Field-level F1:适合部分字段可选的JSON;
- Semantic Validator:检查PromQL、SQL或过滤表达式是否满足约束;
- Execution-based:在隔离环境执行,检查结果与副作用。
参数Schema合法不代表业务正确。service_id存在但指向错误租户,仍是严重失败。
10. Trajectory评测
开放Agent可能存在多条正确路径,因此不应只比较完整Action序列字符串。可以评估:
- Required Tool Coverage:必需工具是否调用;
- Forbidden Action Rate:禁止动作是否出现;
- Redundant Step Rate:重复或无效步骤占比;
- Recovery Rate:Tool Error后是否正确重试、降级或终止;
- Budget Violation:是否超过Step、Token、Cost或Deadline;
- State Consistency:Resume后是否从持久状态继续;
- Final Task Success:最终目标是否完成。
如果业务有确定的Workflow,可以对状态迁移做严格校验;如果允许多条路径,则应以约束和结果为主,轨迹相似度只作为诊断指标。
11. 离线测试与端到端测试
11.1 离线测试
离线测试用于定位组件:
- Retrieval与Rerank使用冻结知识快照;
- Tool Contract覆盖正常、Malformed Input、Timeout、Denied、Retry;
- Planner使用固定Observation做Replay;
- Prompt和Model测试结构化输出、引用与拒答;
- 安全测试使用固定Injection与越权样本。
外部Tool Response、时间、随机性和知识版本应尽量冻结,否则环境波动会混入模型差异。
11.2 端到端测试
端到端测试用于验证完整系统:
- Incident是否得到正确Root Cause与Evidence;
- Tool是否真实调用并遵守权限;
- SSE、取消、恢复与最终状态是否一致;
- P50/P95/P99延迟、Token、API成本;
- 危险动作是否要求Approval;
- 部分依赖失败时系统是否降级或安全终止。
离线高分不保证端到端成功,因为组合后会出现路由、共享状态、预算和错误传播问题;端到端失败也必须沿Trace回到具体组件。
12. 评测集构建
AgentOps的一个Case至少包含:
case_id
incident_snapshot: metrics / logs / topology / time_window
user_query
gold_root_cause
gold_evidence: metric / log / chunk / graph_path / code_location
acceptable_actions / forbidden_actions
required_tools / optional_tools
difficulty / failure_type / service / timestamp
knowledge_snapshot / tool_fixture_version
12.1 数据来源
- 已解决Incident、Postmortem、Runbook;
- 专家设计的边界与安全Case;
- 线上失败Trace经脱敏和复核后回流;
- 合成数据只用于补足稀缺模式,不能替代真实分布。
12.2 标注
由领域专家标Root Cause、最小充分证据集、允许动作和禁止动作。采用双人标注与仲裁;多根因任务允许多个可接受答案。记录标注指南版本,并用Cohen’s Kappa或Krippendorff’s Alpha观察一致性。
12.3 Hard Negative
- 症状相似但根因不同;
- 旧版本Runbook;
- 同名服务、错误时间窗口;
- 相关但不能支持结论的文档;
- Tool Timeout、Permission Denied、部分数据缺失;
- 无答案、证据冲突、Prompt Injection;
- 看似有效但禁止自动执行的操作。
12.4 切分与泄漏
按Incident、服务族或时间切分Train/Dev/Test。来自同一事故的改写不能散落到不同集合;同一Runbook的近重复Chunk也要做Group Split。用Dev集调参数,Test集只用于最终报告。
13. Baseline实验
13.1 控制变量
冻结:
Dataset / Knowledge Snapshot / Model Version
Prompt Version / Tool Schema / Tool Fixture
Temperature / Seed / MaxStep / Token Budget
Timeout / Hardware / Concurrency
一次只改变一个主要变量。例如:
Baseline: Vector Only
Variant A: BM25 + Vector + RRF
Variant B: BM25 + Vector + RRF + Cross-Encoder如果必须同时修改多个组件,应使用消融实验:A、B、A+B分别测试,判断收益来源和交互效应。
13.2 随机性与重复运行
检索器通常接近确定性,生成和Agent轨迹可能随机。每个Case运行n次,报告:
- Mean、Median、Standard Deviation;
- Pass@1、Pass@k和All-pass@n;
- 最差分位数;
- 每Case配对差值。
若一个Case采样n个结果,其中c个成功,从中选k个时“至少一个成功”的无偏估计为:
Pass@k衡量多次尝试至少成功一次的能力,但会奖励重试预算;All-pass@n衡量连续多次均成功的稳定性。线上只能执行一次的任务应以Pass@1为主,不能用Pass@10掩盖单次可靠性不足。
不要把同一Case多次运行当作独立业务样本扩大样本量。统计单位仍应尊重Case层级。
14. 置信区间与显著性
14.1 Paired Bootstrap
Baseline和Variant在同一组Case上评测,使用配对Bootstrap:
for b in 1..B:
    sample |Q| case indices with replacement
    delta_b = metric_variant(sample) - metric_baseline(sample)

95% CI = percentile(delta, 2.5%, 97.5%)
若区间跨0,当前数据不足以说明差异稳定不为0。统计显著不等于业务显著,还要看Effect Size、延迟和成本。
14.2 二元成功率
对同一Case的成功/失败配对结果,可以使用McNemar Test,重点比较“Baseline失败而Variant成功”和“Baseline成功而Variant失败”的不一致样本。
连续但非正态的每Case指标差,可考虑Wilcoxon Signed-Rank或Permutation Test。选择方法前先明确独立性和配对结构。
15. 回归门禁
门禁应同时覆盖质量、效率、稳定性与安全:
| 维度 | 示例门禁 |
|---|---|
| Retrieval | Recall@20不低于Baseline,NDCG@5提升至少2% |
| Task | Root Cause Hit提升,95% CI下界高于0 |
| Latency | P95增加不超过15% |
| Cost | 平均Token与Tool成本不超过预算 |
| Stability | Timeout和Parser Failure不得上升 |
| Safety | Forbidden Action与ACL泄漏必须为0 |
安全门禁通常是硬约束,不能用平均质量收益抵消一次越权写操作。
16. LLM-as-a-Judge
LLM Judge适合开放文本,但需要:
- 明确Rubric和分档示例;
- 随机交换答案顺序,检查Position Bias;
- 控制答案长度,观察Verbosity Bias;
- Judge同时读取Gold和Evidence,而不只看措辞;
- 与专家评分计算一致性;
- 对关键安全Case人工复核;
- 固定Judge模型、Prompt和版本。
Tool是否执行成功、参数是否越权、Citation是否存在等确定性判断,应优先使用程序和真实Trace,不应交由Judge推测。
17. RAG评测的技术栈表述
“RAG评测”不是单一软件,而是一组评测对象、指标和实验方法。技术栈中应将工具与方法分开,并且只写真实使用过的部分。
技术栈一行版
RAG Evaluation:Gold Evidence 数据集,Recall@K / MRR / NDCG,
Faithfulness 与 Citation Precision/Recall,Trace Replay,Paired Bootstrap
如果确实使用了评测框架,可以写:
RAG Evaluation:RAGAS / DeepEval,自定义 Gold Evidence 评测集,
Recall@K / MRR / NDCG,Faithfulness,Citation Accuracy,回归门禁
如果没有实际接入RAGAS或DeepEval,不应为了丰富技术栈而添加名称。自建评测Pipeline本身可以作为技术能力,但需要说明输入、指标和产物。
与检索技术栈合并
Retrieval & Evaluation:BM25 + Milvus + Neo4j,RRF融合与Cross-Encoder重排;
使用Recall@K、MRR、NDCG和Citation指标进行离线评测,
通过Trace Replay与配对Bootstrap执行版本回归。
这类写法比“Milvus / RAG / RAGAS”更有效,因为它表明候选如何产生、如何排序、如何判断改进是否成立。
项目描述版
构建基于Gold Answer与Gold Evidence的RAG评测集,覆盖精确词项、
语义改写、多跳关系、无答案和冲突证据场景;分层评估Retrieval、
Rerank、Context与Generation,使用Recall@5、MRR@5、NDCG@5、
Faithfulness和Citation Precision定位失败,并以配对Bootstrap和
质量/延迟/安全回归门禁比较Vector Only与Hybrid Retrieval方案。
面试口述版
我没有把RAG只测成一个最终答案分数,而是按Retrieval、Rerank、Context和Generation分层。评测集同时标Gold Answer和Gold Evidence:召回看Recall@K,首个正确结果的位置看MRR,多级相关性排序看NDCG;生成侧按Claim检查Faithfulness和Citation。Baseline与改进方案使用相同知识快照和模型,按Case配对比较并做Bootstrap置信区间,最后设置质量、P95、成本和安全门禁。
如果技术栈栏空间很短
优先保留最能证明方法闭环的内容:
RAG Eval:Gold Evidence、Recall@K / NDCG、Faithfulness / Citation、Trace ReplayMRR和NDCG不需要全部写入同一条技术栈描述;可以在正文或面试中展开公式与适用场景。技术栈条目用于说明能力范围,项目描述用于提供设计、实现和对比实验的证据。
18. 项目回答
我们将评测拆成Retrieval、Tool、Trajectory、Answer和System五层。检索同时报告Recall@K、MRR、MAP和NDCG;多证据任务以Recall和NDCG为主,MRR只衡量第一条相关证据的位置。Tool分别测选择、Schema、参数语义和真实执行。评测集标注Root Cause、Gold Evidence、允许与禁止动作,按Incident和时间分组切分。Baseline实验冻结模型、知识快照、Tool Fixture和预算,通过消融实验控制变量;对同一Case做配对Bootstrap或适当的配对检验,并设置质量、P95、成本和安全回归门禁。
19. 高频追问
- Precision@K、Recall@K和Hit Rate@K分别适合什么目标?
- MRR为什么不能衡量多证据覆盖?
- MAP与NDCG的差别是什么,何时需要分级相关性?
- Macro与Micro平均为什么会给出不同结论?
- 无Gold或多答案Case如何进入评测?
- Tool Schema通过为什么仍不能说明参数正确?
- 多条合法Agent轨迹怎样评测?
- 为什么Baseline与Variant应该按Case配对比较?
- 置信区间跨0意味着什么,又不意味着什么?
- 离线指标提升而端到端下降,应沿哪些Trace字段定位?