Agent 运行时
结合 AgentOps 项目回答长任务状态、SSE 补放、Redis/SQLite 分工、取消语义与可审计 Trace。
Agent 运行时
当Agent任务变成长时间运行的异步任务时,连接、任务、事件和审计必须解耦。浏览器断线不应终止Worker;Redis消息已发布不表示事件可回放;普通日志也不足以完整复现一次回答的形成过程。
项目背景
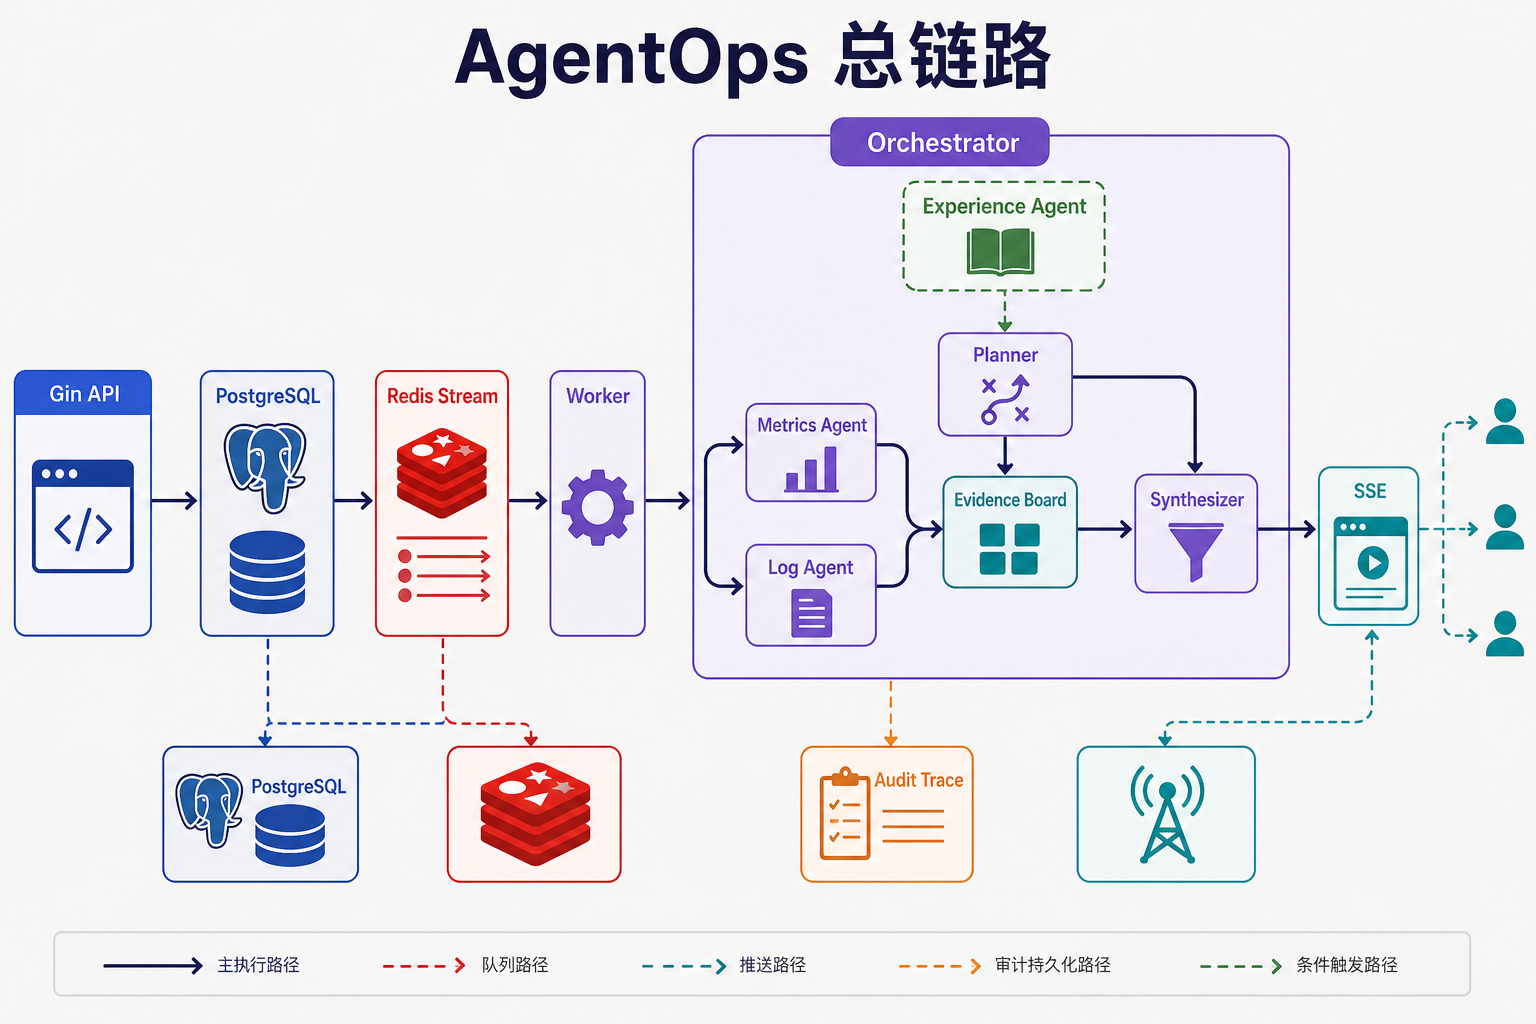
AgentOps使用Go / Gin + CloudWeGo Eino编排故障诊断:Metrics Agent查Prometheus,Log Agent查Loki,Experience Agent查Neo4j、Milvus和CodeGraph MCP,Synthesizer基于Evidence Board生成RCA。任务通过Redis Stream调度,进度通过SSE推送,事实和审计数据落持久库。
SSE断联处理
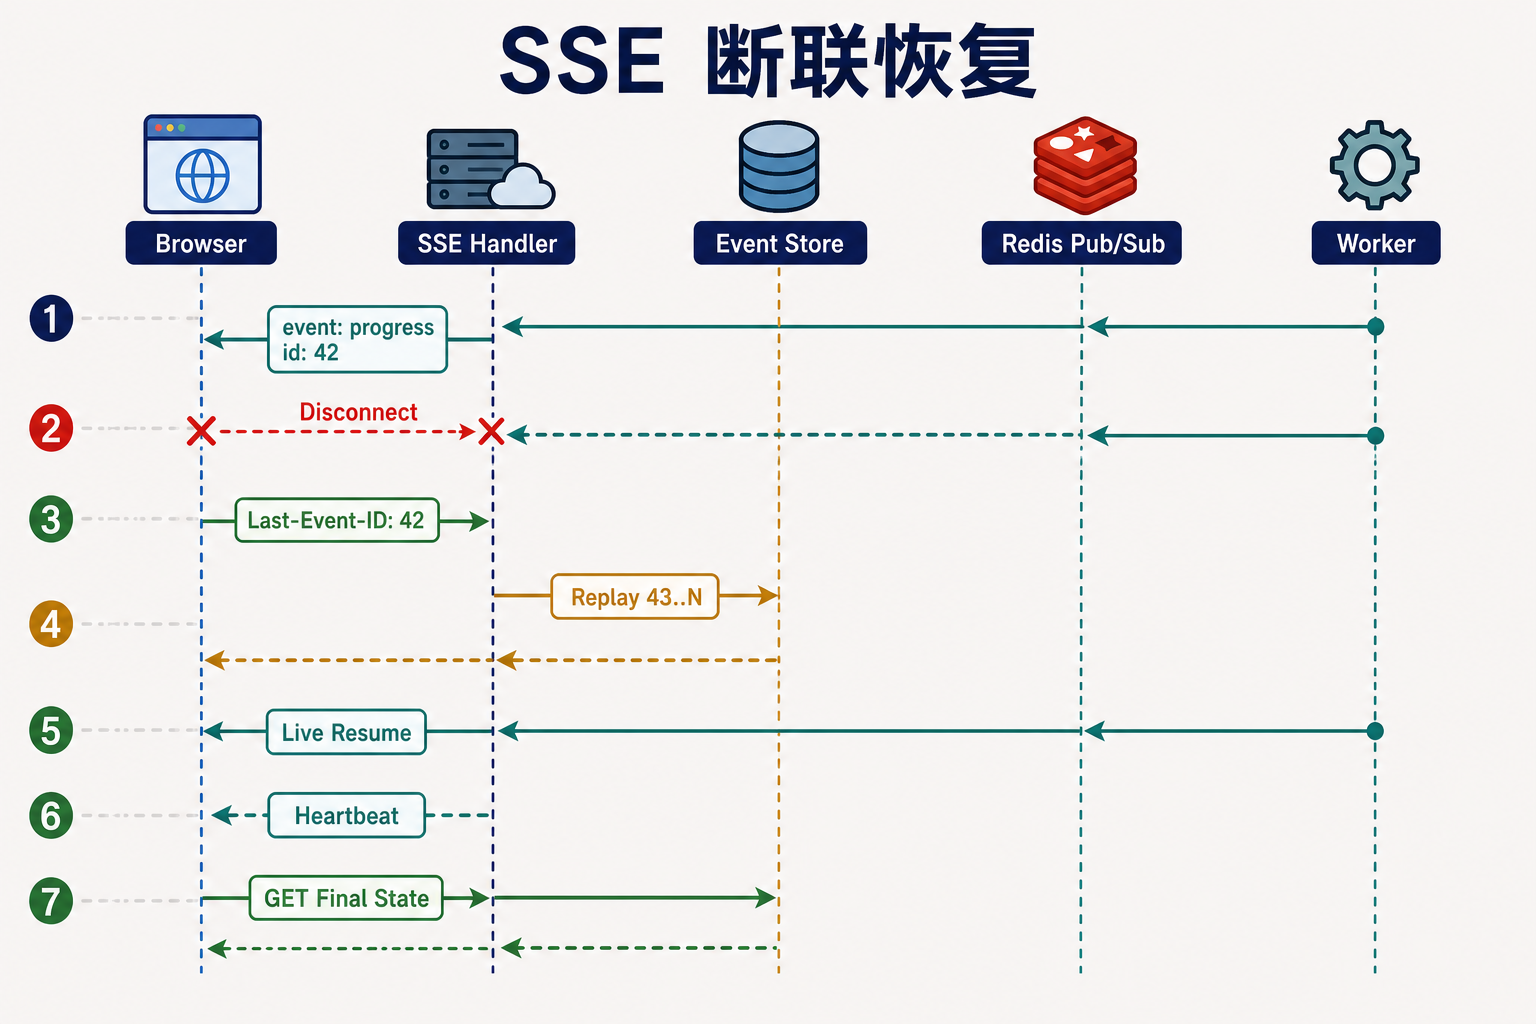
Agent诊断进度是Server → Browser单向流,因此SSE比WebSocket更符合需求:它复用HTTP语义,浏览器原生支持EventSource、文本事件和自动重连。但自动重连只能恢复连接,不能自动补回断线期间丢失的事件。
每个事件至少包含:
id: 43
event: agent_done
data: {"incident_id":"inc-7","agent":"metrics","status":"done"}客户端重连时发送Last-Event-ID。服务端正确恢复顺序是:
- 先订阅实时通道,将新事件暂存;
- 读取持久事件表当前Watermark;
- 补放
(last_id, watermark]; - 按Event ID合并暂存事件并去重;
- 切入实时转发。
需要先订阅再补历史。如果先查历史、再订阅实时,两步之间会形成短暂的事件丢失窗口;该问题通常具有低频和时序相关特征,因而容易只在生产环境出现。
心跳用于尽早发现TCP已经断开,并推动代理层Flush;超过事件保留期则返回resync_required,让客户端调用GET /incidents/{id}拿当前快照。
连接生命周期不能绑定任务生命周期
SSE断开只表示用户暂时看不到进度,不等于用户取消任务。显式取消另走POST /incidents/{id}/cancel,API更新任务状态并通过context cancellation通知Worker。Worker在每个长工具调用和阶段边界检查Context,最终再发布cancelled事件。
Pub/Sub的可靠性边界
Redis Pub/Sub只管直播,不管回放;订阅者离线期间错过就是错过。可以采用三类设计:
- SQLite/PostgreSQL Event Table + Pub/Sub:持久表补历史,Pub/Sub推实时;
- Redis Stream:事件本身可按ID回放,并有Consumer Group;
- Kafka:更长保留、多消费者与高吞吐,但运维成本更高。
无论哪种,客户端按Event ID幂等处理;服务端发布事件也要考虑数据库成功但实时通知失败,可用Outbox或让Stream成为单一事件源。
小规模Agent服务中的Redis与SQLite分工
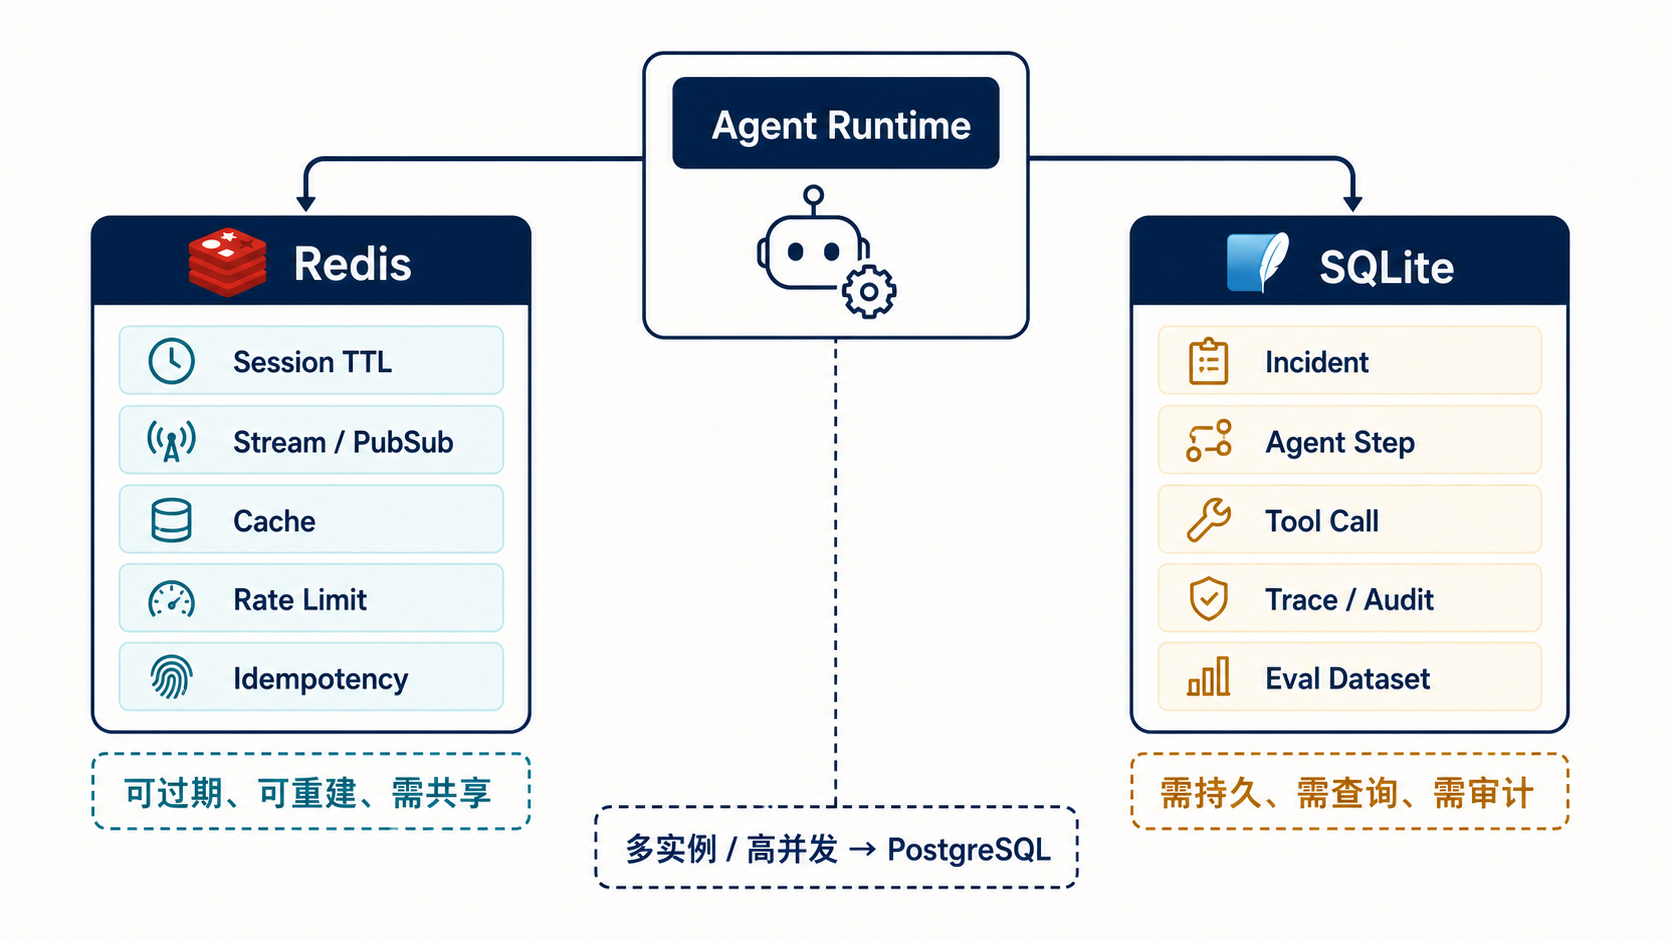
基本原则是:Redis保存短生命周期、高频访问且可重建的状态;SQLite保存需要持久化、查询和审计的事实。
Redis:热状态与协调
- Session热状态、最近对话摘要、当前阶段,带TTL;
- Redis Stream任务队列与Pending状态;
- SSE实时Pub/Sub;
- Model/Embedding缓存;
- Rate Limit、Idempotency Key、短Lease;
- 多实例需要共享但可由持久库恢复的运行态。
SQLite:事实、查询与审计
- Incident、Task、Agent Step、Tool Call、Approval;
- Trace、事件补放、Prompt和Model版本;
- Eval Dataset、Gold Answer、Gold Evidence、评测结果;
- 用户与工具配置、Manifest和索引Version;
- 小规模文档Metadata与FTS5索引。
SQLite开WAL Mode后适合单机读多写少,但仍是单写者模型。多实例、高写并发和强HA需求出现后迁PostgreSQL。Blob、大段原始模型输出、图片放对象存储,数据库只存URI、Hash和Metadata。
Trace Recorder设计
普通日志记录离散事件,Trace用于还原一次RCA的完整因果链。每个Incident分配一个trace_id,并为Agent Step、Model Call、Tool Call和Retrieval分别建立Span。
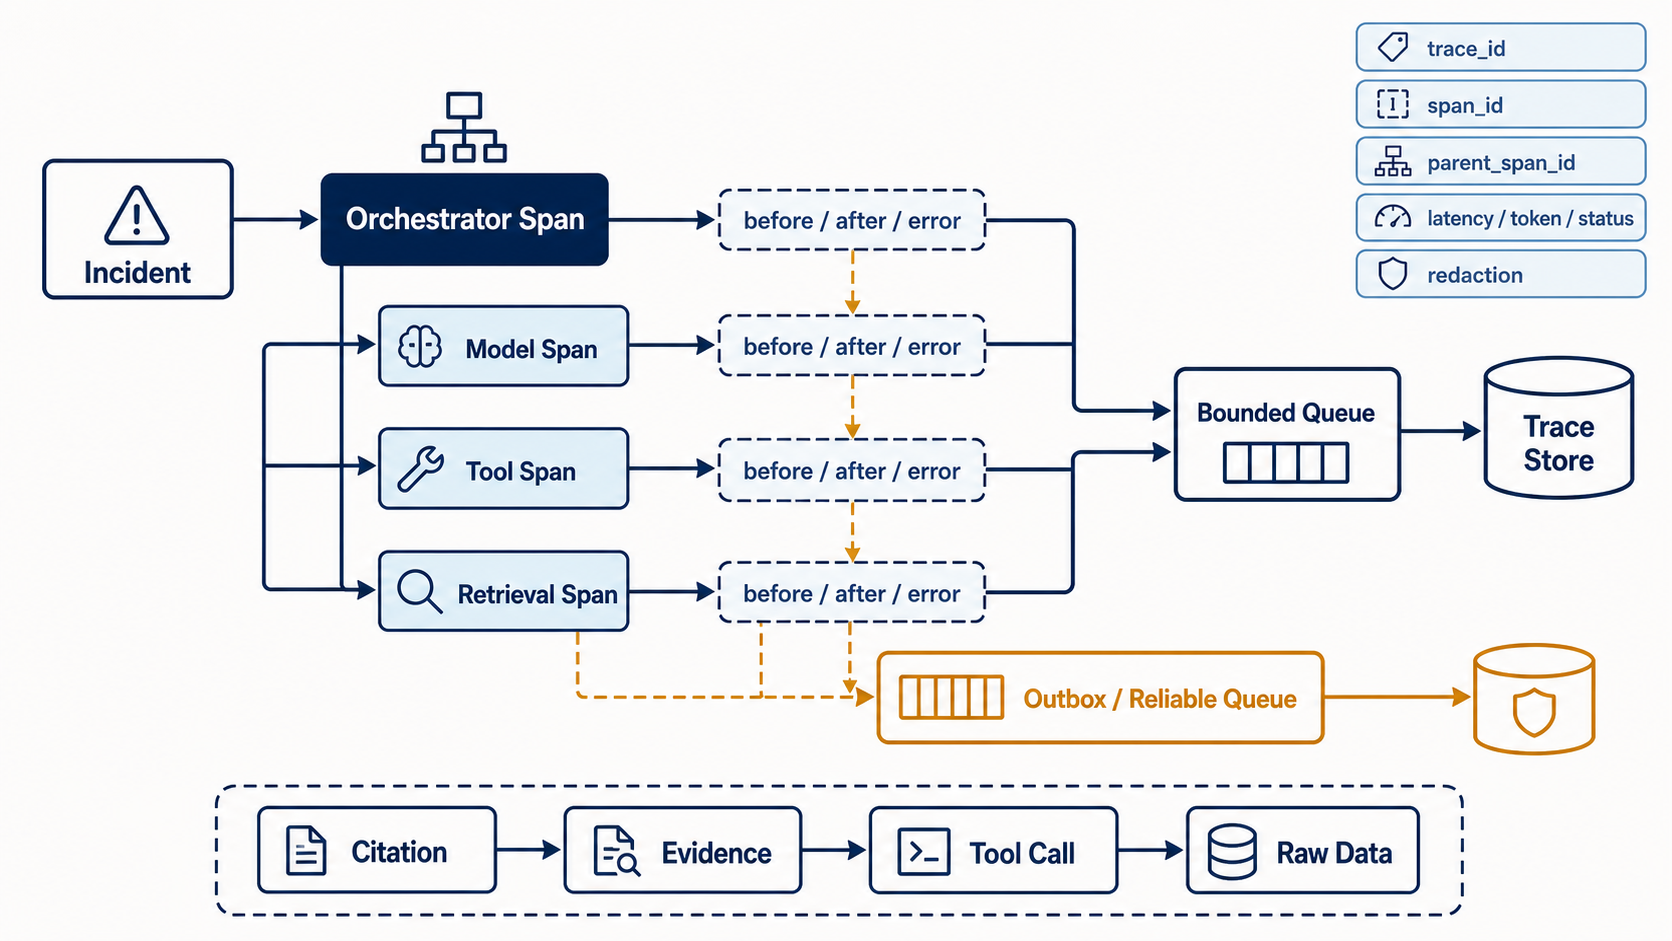
推荐字段:
trace_id, span_id, parent_span_id
incident_id, agent_name, step_index, span_type
tool_name, arguments_redacted, status, error_code
started_at, ended_at, latency_ms
model, prompt_version, input_tokens, output_tokens
retriever, raw_score, fused_rank, chunk_id, version_id
request_hash, response_hash, payload_uri
实现上通过Eino Callback或统一Tool Wrapper,在before / after / error三个阶段开闭Span。Trace Context放在context.Context传播,不使用全局变量;Tool无论成功、超时、拒绝还是异常都必须闭合Span。
Observability与Audit可靠性不同
普通观测Span可进入有界内存队列异步批量落库,队列满时允许采样或丢弃并报警;审批、外部写操作、权限拒绝和最终Evidence属于关键审计事件,不能只放进程内队列,应通过同事务Outbox或可靠消息源持久化。
大Response存入对象存储,Trace表保留Hash和URI。Prompt、Authorization、Cookie、Secret和用户隐私需要先脱敏。在线上下文只传递Summary与Evidence Pointer,避免将完整审计数据重新放入模型上下文。
最终应能完成:
Citation → Evidence → Retrieval Hit → Tool Call → Raw Data故障场景测试
- SSE在补放期间再次断线,客户端是否仍能按Event ID收敛;
- Pub/Sub发布失败但事件表成功,重连能否拿到结果;
- Worker重启后能否从持久状态恢复,而不是根据Prompt推断执行进度;
- Tool超时、Context Cancel时Span是否闭合;
- Trace队列满时是否影响主链路,关键Audit是否仍不丢;
- 重复事件和乱序到达时前端状态机是否幂等。
项目回答模板
SSE只承载进度,不承载任务生命周期。每个事件有单调ID并先持久化,客户端用Last-Event-ID重连;服务端先订阅实时流,再按Watermark补历史并去重,避免补放与订阅之间的空窗。Redis保存热状态、队列和实时通知,SQLite保存Incident、Step、Trace与评测事实。Trace通过统一Wrapper记录Model、Tool、Retrieval Span,普通观测异步写,关键审批和副作用Audit走Outbox可靠持久化。
高频追问
- 为什么
EventSource自动重连仍会丢事件? - 先Replay再Subscribe有什么Race Condition?
- SSE断开为什么不能直接Cancel Worker?
- SQLite WAL Mode改善什么,又没有解决什么?
- Trace与普通业务日志的字段和用途有何区别?
- 为什么关键审计事件不能只写异步内存队列?