Grafana 与信号关联
Grafana Data Source、Dashboard、Explore与Alerting,以及Metrics、Traces、Logs如何关联成AgentOps排障与回归闭环。
目录 · 34 节
- 1. 组件职责边界
- 2. Dashboard、Explore与Alerting
- Dashboard
- Explore
- Alerting
- 3. Data Source与关联键
- 4. 关联排障流程
- 第一步:Metrics确认影响
- 第二步:Trace定位慢步骤
- 第三步:Logs解释原因
- 5. Dashboard设计
- 第一层:用户症状
- 第二层:依赖与饱和度
- 第三层:Agent执行质量
- 6. 变量、Annotation和Data Link
- 7. Alerting的工程细节
- 分组与路由
- 8. SLO告警优于原因告警
- 9. Dashboard与告警即代码
- 10. Agent与Grafana协作
- 11. AgentOps可观测性设计
- Metrics Agent
- Log Agent
- Trace Agent或Trace Tool
- Evidence Board
- 12. Incident向测试资产的回灌
- 13. 可观测性系统测试
- 14. 高频追问
- Grafana是不是监控数据存储?
- 为什么不让Agent直接查询Grafana?
- Metrics、Logs和Traces应该先看谁?
- Dashboard很多是否代表可观测性好?
- 如何避免告警风暴?
- 参考资料
Grafana 与信号关联
Grafana为Prometheus、Loki、Tempo等Data Source提供统一的查询、关联、可视化和告警入口。有效的Grafana设计应支持运维人员沿证据链定位问题,而不是依赖大量缺乏层次和关联关系的Panel。
1. 组件职责边界
| 组件 | 主要职责 | 查询语言 |
|---|---|---|
| Prometheus | 指标采集、时间序列存储、规则计算 | PromQL |
| Loki | 日志接收、Stream存储和查询 | LogQL |
| Tempo | Trace存储与查询 | TraceQL / Trace ID |
| OpenTelemetry | 埋点、上下文传播、采集处理和导出 | OTLP |
| Grafana | Data Source查询、Dashboard、Explore、Alerting | 调用各后端查询 |
Grafana自身会保存用户、Dashboard定义、Data Source配置等元数据,但业务Telemetry仍存储在对应后端。Grafana不能替代Prometheus、Loki或Tempo的采集与存储能力。
2. Dashboard、Explore与Alerting
Dashboard
用于持续观察已知问题:
- 服务健康概览;
- RED与USE指标;
- SLO和Error Budget;
- Agent任务、Tool、模型、检索与成本;
- 发布版本和Incident Annotation。
Explore
用于临时调查未知问题:
- 修改PromQL、LogQL和Trace查询;
- 并排比较不同信号;
- 查看日志上下文;
- 从Trace跳Logs、Metrics与Profiles;
- 围绕一个时间窗和服务逐步缩小范围。
Alerting
周期执行查询与表达式,Reduce成可判断值,产生Alert Instance,再根据Label、Contact Point和Notification Policy完成分组、路由与通知。
Query
→ Reduce / Math / Threshold
→ Pending
→ Firing
→ Notification Policy
→ Contact Point
三者不能互相替代:Dashboard用于持续展示,不能主动通知;Alert只能说明规则条件得到满足,不能自动解释根因;Explore适合临时调查,不适合替代自动化监控流程。
3. Data Source与关联键
让三种信号真正关联,需要统一Resource和Context:
service.name
deployment.environment
service.version
cluster / namespace
trace_id / span_id
timestampservice.name必须在三种信号中保持一致。例如,Metrics、Logs和Traces不应分别使用checkout、checkout-api和order-service-v4-pod-7f9d表示同一服务。
关联配置通常包括:
- Prometheus Exemplar → Tempo Trace;
- Tempo Trace to Logs → Loki查询;
- Tempo Trace to Metrics → Prometheus查询;
- Loki字段或Data Link → Trace View;
- Dashboard变量统一传递service、environment和时间窗。
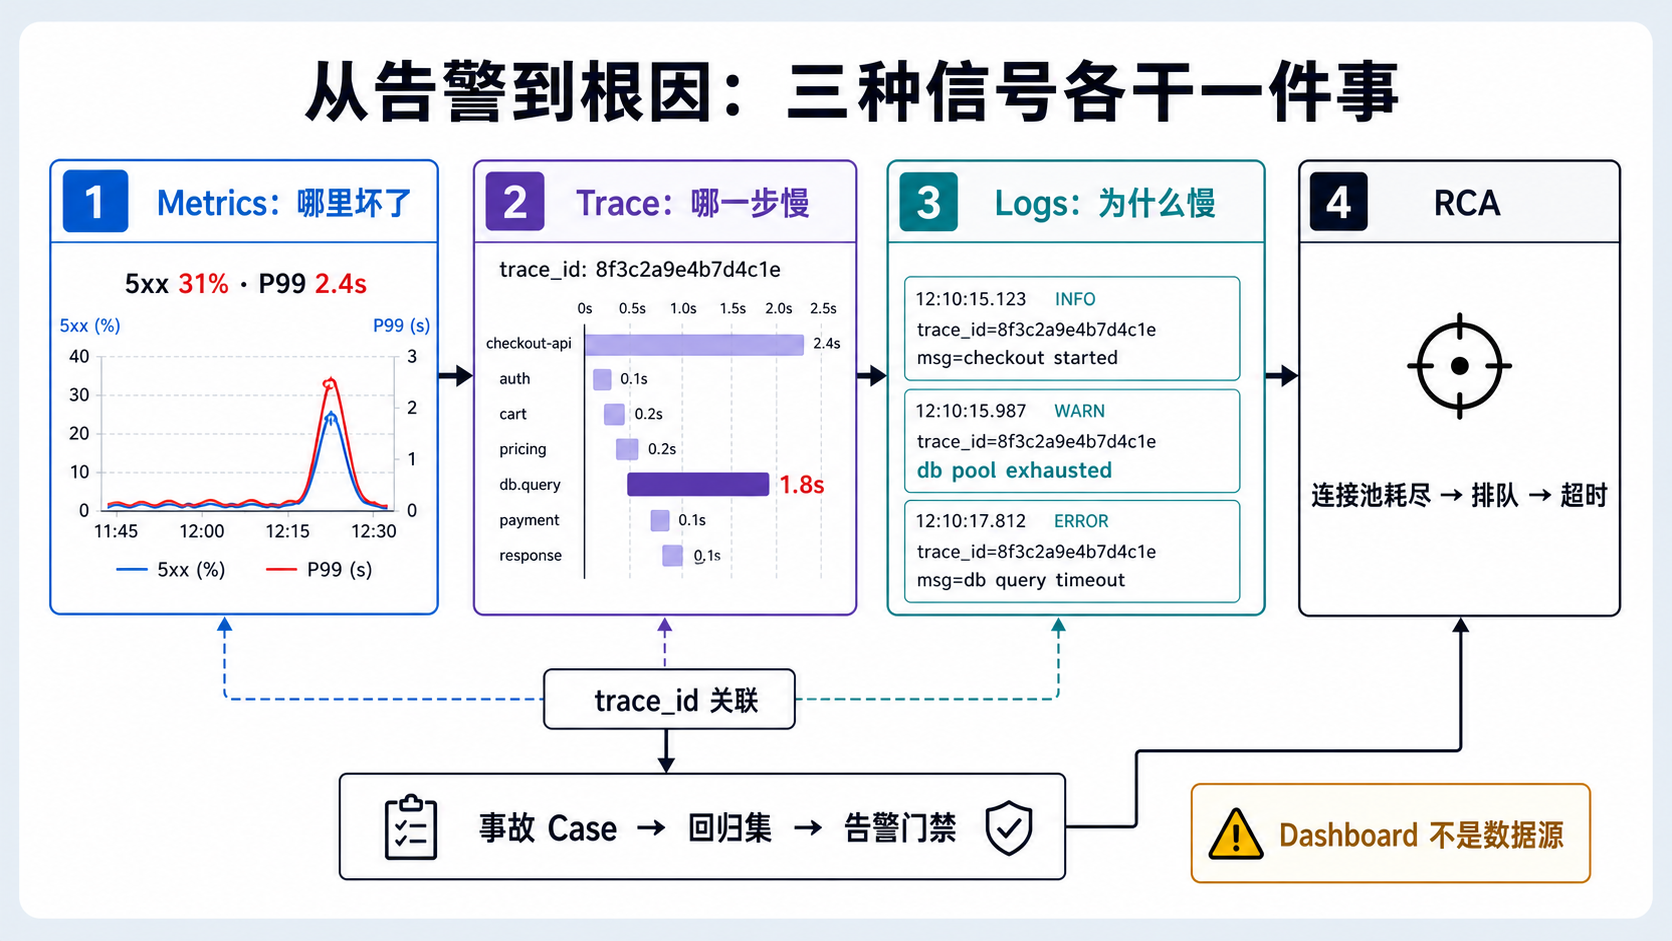
4. 关联排障流程
假设Grafana告警:
checkout-api
5xx = 31%
P99 = 2.4s
started_at = 10:20
第一步:Metrics确认影响
先确认:
- 是错误率还是流量变化造成绝对错误数上升;
- 哪些Route、Region、Version受影响;
- P50、P95、P99是否同时变化;
- CPU、内存、队列、连接池和下游是否饱和;
- 是否与发布Annotation时间吻合。
Metrics将故障范围从整个系统缩小到“checkout-api新版本的订单路径从10:20开始出现性能退化”。
第二步:Trace定位慢步骤
点击异常点Exemplar,或按服务、错误、Duration和时间窗查Tempo:
HTTP POST /orders    2.4s
└─ db.query          1.8s  ERROR
现在知道不是模型生成慢,也不是支付服务慢,而是获取或执行数据库操作占据主要时间。
第三步:Logs解释原因
从失败Span跳到Loki,并带入trace_id与Span时间窗:
WARN  db pool exhausted       wait_ms=1200
ERROR db query timeout        timeout_ms=1500
最终证据链:
连接池耗尽
→ 请求等待连接
→ db.query Span长尾
→ Handler Deadline耗尽
→ 5xx和P99同时升高
完整RCA应说明故障机制及其因果链。仅得出“数据库慢”的结论不足以支持修复和预防措施。
5. Dashboard设计
第一层:用户症状
第一层用于判断服务整体健康状态:
- 请求量;
- 成功率和错误率;
- P50 / P95 / P99;
- SLO、Error Budget与Burn Rate;
- 当前发布版本;
- 正在Firing的告警。
第二层:依赖与饱和度
- 数据库连接池与慢查询;
- Kafka Lag、消费失败和重试;
- Redis命中率、Eviction和延迟;
- 外部API错误与Deadline;
- CPU、Memory、GC和队列。
第三层:Agent执行质量
- Task Success和停止原因;
- Planner Step、Loop和Replan;
- Model TTFT、Token、缓存命中和限流;
- Tool P95、错误、重试、审批拒绝;
- Retrieval耗时、空结果和Index Version;
- 每成功任务成本;
- 人工接管和安全策略命中。
Panel必须标明单位、统计窗口、过滤条件和数据缺失语义。0可能表示没有错误,也可能表示Scrape失败;空白Panel也不能直接解释为系统正常。
6. 变量、Annotation和Data Link
Dashboard变量减少复制:
$environment
$cluster
$service
$version
$tenant_bucket
变量值要受控,避免直接拼接用户输入形成昂贵或越权查询。
Annotation将发布、配置变更、扩缩容和Incident叠加在时间轴上。例如,10:20开始的异常可能与10:18的发布相关;缺少Annotation时,需要通过其他系统额外检索变更记录。
Data Link负责从Panel跳转:
错误率Panel
→ Explore中的相同PromQL和时间窗
→ Tempo Trace
→ Loki Logs
→ Runbook / Deployment / Incident
链接应携带服务、环境和时间范围,减少人工复制ID时制造的新事故。
7. Alerting的工程细节
一条能用的Alert Rule需要:
| 元素 | 作用 |
|---|---|
| Query | 计算症状或SLI |
| Reduce | 将时间序列化为一个可比较值 |
| Condition | 阈值或数学表达式 |
for | 必须持续满足多长时间 |
| Labels | severity、service、team、environment |
| Annotations | summary、impact、dashboard、runbook |
| No Data / Error | 查询无数据或失败时怎样处理 |
告警状态要区分:
- Normal:条件未满足;
- Pending:已满足但没超过持续时间;
- Firing:正式触发;
- Recovering:数值正在恢复,尚未满足稳定恢复条件;
- No Data / Error:不是业务健康,而是判断依据缺失或查询失败。
分组与路由
Notification Policy通常按team、service、severity分组。相关实例应合并,避免同一集群中的大量Pod为同一故障分别发送通知。
group_wait:首次通知前等待相关告警聚合
group_interval:同一组变化后多久再通知
repeat_interval:持续未恢复时多久提醒一次
Silence用于在限定范围和时间内静默匹配告警;Inhibition用于在高层故障发生时抑制派生告警,例如Cluster Down时不再为每个Pod发送单独告警。两者都需要Owner和过期时间,不应使用永久静默替代规则治理。
8. SLO告警优于原因告警
对于在线任务,定义:
Good = success
       AND latency <= 30s
       AND unsafe_action = false
然后用短窗口快速Burn和长窗口持续Burn组合告警:
短窗口:快速发现猛烈故障
长窗口:过滤短暂的瞬时波动
这样Page表达“用户错误预算正在快速消耗”,Dashboard再帮助查CPU、数据库、Loki、模型或Tool。对每个底层原因都Page会导致告警风暴;只看底层资源又可能错过功能正确性下降。
9. Dashboard与告警即代码
生产环境不应依赖个人在Web界面中手工维护配置。以下资源应纳入版本控制:
- Data Source Provisioning;
- Dashboard JSON或生成源码;
- Alert Rule、Contact Point和Notification Policy;
- Recording Rule;
- Folder、权限和Owner;
- 不同环境的参数覆盖。
CI检查:
- JSON/YAML语法;
- 查询可以解析;
- 变量和Data Source UID存在;
- Alert包含Owner、Runbook和严重级别;
- PromQL/LogQL用Fixture验证;
- Dashboard截图或结构Diff接受Review;
- 变更可回滚。
10. Agent与Grafana协作
正确架构是双消费方:
Prometheus / Loki / Tempo
├─ Grafana:给人类Explore、Dashboard、Alert
└─ Agent Tools:受限PromQL、LogQL、Trace查询API
Agent不需要通过Grafana截图识图,也不应该持有任意查询能力。Tool层应限制:
- 允许的数据源和租户;
- Query模板或AST;
- 最大时间窗、Series和返回行数;
- 超时、并发与成本;
- 禁止危险正则和无界查询;
- 返回结构化Observation与Evidence ID;
- 记录查询Hash、Span、策略决策和结果URI。
Grafana用于人工验证Agent结论:通过Citation进入对应Panel、Trace或Log Context,确认Synthesizer使用的是当前事故的有效证据,而不是不相关的历史日志。
11. AgentOps可观测性设计
Metrics Agent
用受控PromQL查询:
QPS / 5xx / P99
CPU / Memory / Queue
DB Pool / Kafka Lag / Cache Hit
deployment version
Log Agent
用受控LogQL查询:
error / timeout / panic
trace_id上下文
错误类型聚类
发布前后日志差异
Trace Agent或Trace Tool
查询:
错误Trace
长耗时Span
关键服务路径
跨Agent委派与Tool调用
Evidence Board
所有结果统一成:
{
  "evidence_id": "log-42",
  "signal": "logs",
  "source": "loki",
  "query_hash": "...",
  "time_range": ["10:19", "10:24"],
  "service": "checkout-api",
  "trace_id": "8f3c...",
  "summary": "db pool exhausted",
  "raw_uri": "evidence://incident-17/log-42"
}Synthesizer引用evidence_id生成RCA;Grafana Data Link或内部Evidence页面让人回到Raw Data。运行时事实权重高于历史RAG经验:历史案例说“可能是锁”,当前Metrics和Logs没看到锁等待,就只能当候选方向。
12. Incident向测试资产的回灌
Alert触发
→ 保存Dashboard时间窗、Trace与关键Logs
→ 生成脱敏Incident Bundle
→ Agent复盘并由人确认Root Cause
→ 形成Regression Case
→ 补单元、集成、E2E或离线Eval
→ 修订Alert和Runbook
每个Case保存:
service / environment / version
query + time range + result digest
trace_id / span_id / evidence_id
expected root cause
required evidence
forbidden action
latency / tool / token budget
回放时注入历史Observation,不重新执行生产写操作。Grafana提供事故分析入口,Trace Recorder维护证据链,Eval Harness用于验证新版本能否识别同类事故。
13. 可观测性系统测试
- 埋点单测:名称、类型、Label和单位;
- 传播契约:HTTP、gRPC、Kafka的Trace Context;
- 管道集成:应用→Collector→后端;
- 查询测试:PromQL、LogQL和Trace查询使用固定Fixture;
- Dashboard测试:变量、Data Link、空数据和权限;
- 告警测试:Firing、Recovery、No Data、Query Error;
- 通知测试:分组、路由、Silence和升级;
- 故障注入:Collector宕机、Loki 429、Prometheus磁盘满、Tempo丢Span;
- GameDay:从告警到定位、缓解、恢复和复盘全流程计时。
关键指标是MTTD和MTTR,但还应记录告警精确率、无行动告警比例、Runbook命中率、Trace完整率与Telemetry丢失率。
14. 高频追问
Grafana是不是监控数据存储?
不是主要Telemetry存储。它查询Prometheus、Loki、Tempo等Data Source,并提供展示、Explore和Alerting;Dashboard配置等元数据由Grafana自身保存。
为什么不让Agent直接查询Grafana?
Grafana主要为人类交互设计。Agent直接使用受限的后端查询Tool更稳定、结构化、容易授权和审计;Grafana保留为人工验证入口。
Metrics、Logs和Traces应该先看谁?
通常先用Metrics确认症状和影响范围,再用Trace定位缓慢或失败的步骤,最后用Logs解释具体原因。若告警直接携带Trace ID,也可以从Trace开始分析;实际顺序取决于已有入口,但必须保持关联键和证据链完整。
Dashboard很多是否代表可观测性好?
不代表。要看用户症状能否被发现、查询是否可关联、告警是否可行动、Telemetry是否完整,以及事故能否沉淀为可复现Case。
如何避免告警风暴?
按用户症状和SLO告警,使用for、恢复阈值、分组、路由与Inhibition;为告警设置Owner并定期删除没有行动价值的规则。