Kafka
从 Record Batch 到 ISR、HW、Consumer Offset 与事务,说明 Kafka 各阶段成功语义的有效边界。
Kafka
Kafka不要先想成一个比较快的Queue,先想成按Partition拆开的分布式追加日志。Topic负责逻辑命名,Partition才是有序边界;Partition又滚成Segment,Record组团成Record Batch。套娃开始了,但每一层确实都有活干。
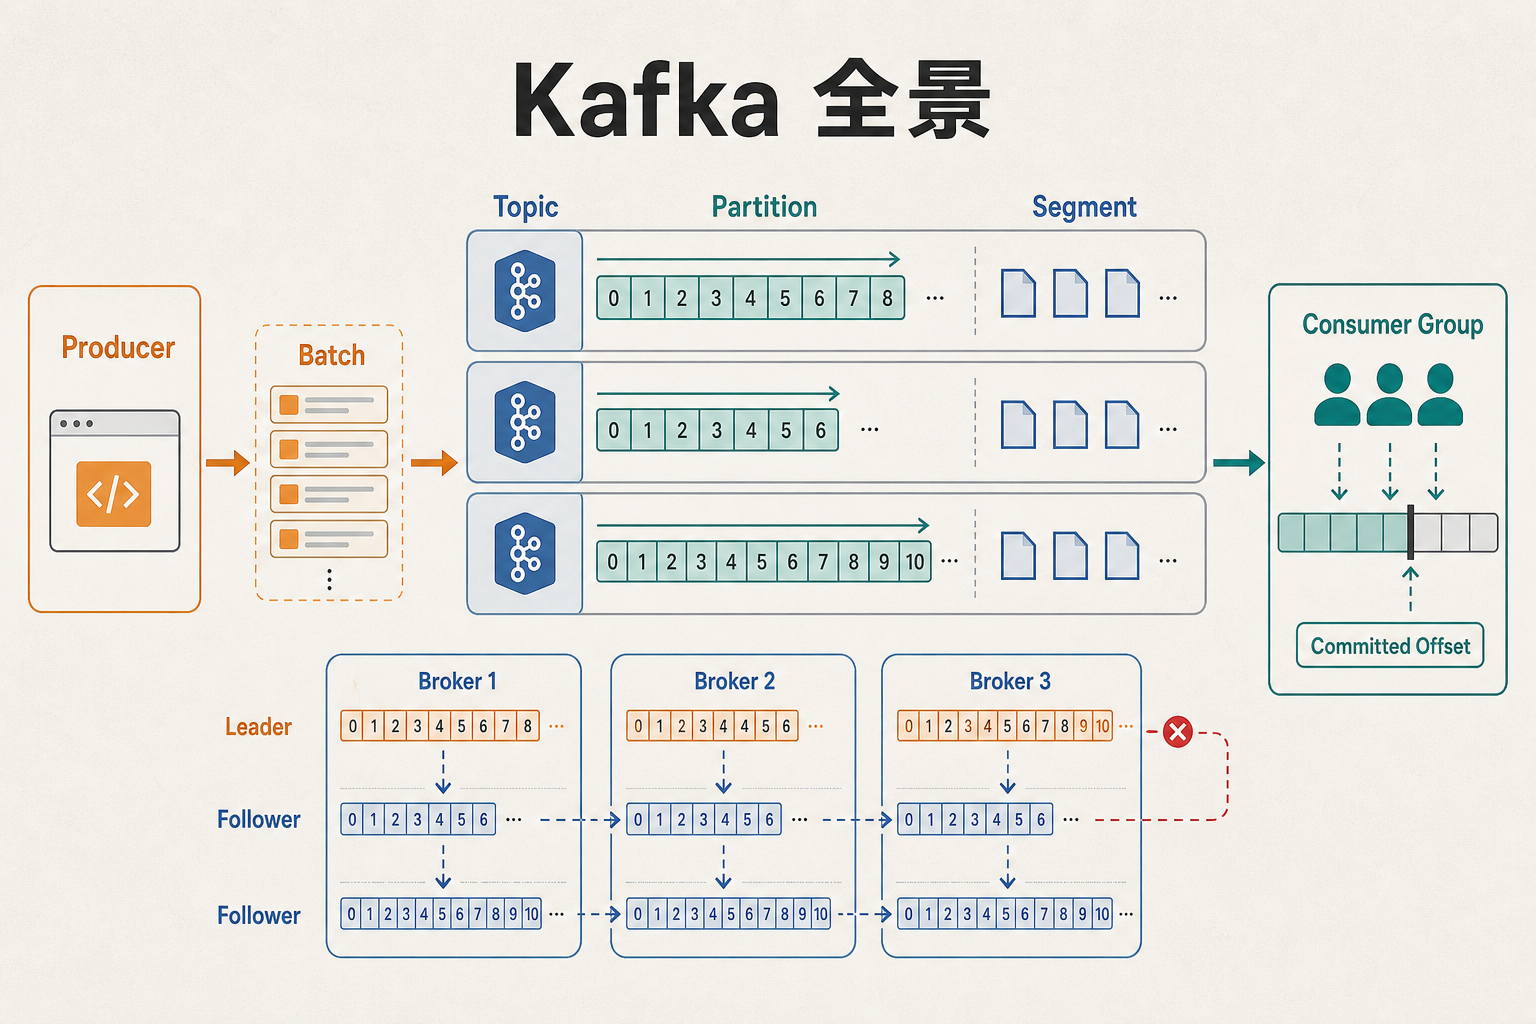
一条消息的完整数据路径
Producer
→ Serializer / Partitioner
→ RecordAccumulator 按 Topic-Partition 聚合 Batch
→ Leader 追加 Local Log
→ Follower Fetch 复制
→ Consumer Fetch Batch
→ 业务处理
→ Commit 下一次恢复 OffsetProducer的batch.size是单个Topic-Partition批次的容量上限,linger.ms允许Sender短暂等待更多Record。Batch更充分时,请求、系统调用和压缩开销可以由更多消息分摊,吞吐和压缩率通常更高;低流量下则可能增加排队延迟。
性能实验必须固定消息大小、Partition数、acks、压缩算法和Broker配置,只改变Batch与Linger参数,同时观察Throughput、P50/P95/P99、平均Batch大小、CPU和网络字节。仅观察每秒消息数会遗漏尾延迟变化。
Partition的顺序边界
同一个Partition内,Leader按照Offset追加记录,Consumer也按Offset读取,因此可以讨论分区内顺序。Topic包含多个Partition时不存在一个廉价的全局Offset,跨Partition到达顺序、处理顺序都不保证。
带Key的消息通常按Key选择Partition,因此相同Key在分区数不变时会进入同一分区;但Partition数量改变后,简单取模映射可能变化。强依赖顺序的业务需要将分区数、分区策略和Key设计共同视为数据契约,并为扩容设计迁移方案。
Offset是Partition内单调递增的逻辑位置,不是数组下标,也不是.log文件字节地址。Retention或Compaction删除旧Record后,后续Offset不会重新编号。
Segment、稀疏索引与Page Cache
Partition在磁盘上由多个Segment组成,Active Segment接收追加。每个Segment通常有.log、.index、.timeindex等文件;文件名使用base offset。查询Offset时先定位Segment,再用稀疏索引找到不大于目标Offset的邻近物理位置,最后顺序扫描Record Batch。
Kafka的高吞吐由顺序追加、批处理、压缩、Page Cache、零拷贝路径以及多Partition并行共同实现。仅归因于“顺序写磁盘”无法完整解释其吞吐机制。
区分复制进度与消费进度
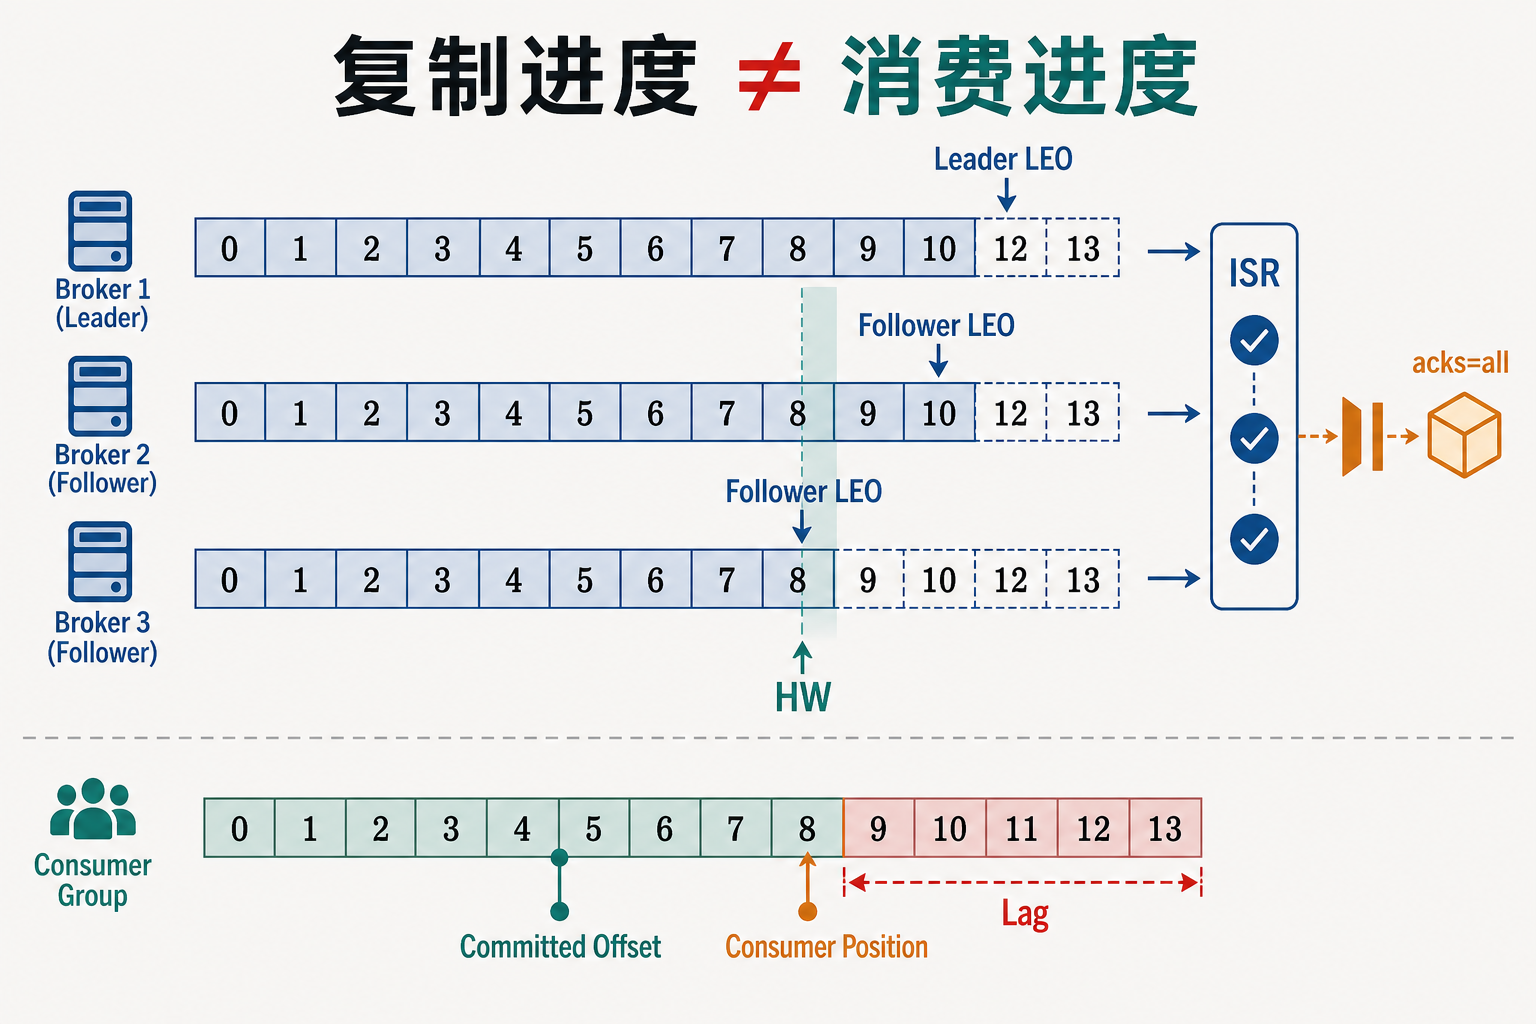
Kafka内部有多种Offset,其语义和推进者并不相同:
| 位置 | 所属语境 | 表达什么 |
|---|---|---|
| LEO | 副本日志 | 该副本下一条写入位置 |
| HW | 副本复制 | 对消费者可见的已复制边界 |
| Consumer Position | Consumer实例 | 下一次准备Fetch的位置 |
| Committed Offset | Consumer Group | 重启或Rebalance后的恢复位置 |
acks=all关心ISR和Broker写入确认;Committed Offset关心业务失败后从哪恢复。前者不能证明业务已处理,后者也不能证明消息复制到多少副本。拿Consumer Lag证明副本安全,基本等于拿体温计测网速,都是数字但关系不大。
ISR、min.insync.replicas 与可用性
假设Replication Factor为3、min.insync.replicas=2、Producer用acks=all。当ISR只剩1个副本时,Broker应拒绝新写入,以牺牲可用性保护确认边界。acks=all不是机械等待全部配置副本,而是按照当前ISR和最小同步副本约束确认。
Leader故障后从ISR选择新Leader,已经确认的数据才有明确保留边界。开启Unclean Leader Election可能从落后的非ISR副本选主,从而缩短不可用时间,但会引入已确认数据丢失的风险。
消费组、Rebalance 与重复消费
一个Consumer Group内,同一Partition同时只分配给一个Consumer;一个Consumer可以承担多个Partition。不同Group可以独立读取同一Partition,因为读取不删除日志。
典型协作流程是Coordinator选择Group Leader、Leader计算分配、SyncGroup下发、Consumer持续Heartbeat并Fetch。成员变化、订阅变化或Partition变化会触发Rebalance。Eager协议可能先撤销全部分配再重分,Cooperative协议尽量渐进迁移,但应用仍要处理暂停、重复和在途任务交接。
如果先处理业务再Commit,处理成功而Commit失败会导致重复消费;如果先Commit再处理,进程在处理完成前终止会导致消息遗漏。生产系统通常选择At-Least-Once,再由下游通过业务幂等键、唯一约束或状态机处理重复。Exactly-Once不能消除所有跨系统不确定性,而是重新定义其事务边界。
Exactly-Once语义边界
幂等Producer通过Producer ID和Sequence Number抑制重试造成的Kafka日志内重复。Kafka Transaction可以把多Partition写入,以及“读某批消息后产生的新消息 + 提交消费Offset”放进同一个Kafka事务;消费者使用read_committed忽略未提交和已中止事务数据。
外部数据库、HTTP API、短信和邮件不属于Kafka事务边界。跨出该边界后仍需使用:
- Transactional Outbox:业务数据和待发送事件写在同一数据库事务;
- Inbox / Idempotency Key:消费者按业务键去重;
- 唯一约束或条件更新:让重复执行收敛;
- Saga / Compensation:处理不可原子提交的跨服务副作用。
Exactly-Once只在明确声明并实现的事务边界内成立。
项目回答模板
我们将Kafka写入确认、日志复制和业务处理分层分析。Producer按Partition聚合Batch,Leader追加后由Follower拉取复制;
acks=all + min.insync.replicas约束Broker确认边界。Consumer Group独立维护Committed Offset,采用先处理后提交获得At-Least-Once语义,再通过业务幂等键和唯一约束处理重复。Kafka内部读写链路需要强原子性时使用幂等Producer与Transaction;跨数据库副作用使用Outbox,不将Kafka内部的Exactly-Once语义扩展解释为跨系统端到端Exactly Once。
高频追问
- 为什么Topic不能承诺全局顺序,扩Partition为什么可能破坏Key顺序?
- LEO、HW、LSO和Committed Offset分别由谁推进?
acks=all在ISR缩水时如何表现?- Rebalance为什么造成暂停,Cooperative Rebalance改善了什么?
- Retention与Compaction的目标分别是什么,Tombstone为什么不能立即删除?
- Outbox如何避免“数据库成功、消息没发”这条经典裂缝?