测试基础
从测试对象、Oracle、测试分类与反馈层次,到覆盖率、Mutation、风险驱动和 Agent 系统的双重不确定性。
测试基础
软件测试无法证明“系统绝对没有Bug”,只能在一组输入、环境和Oracle下寻找反例,并给发布决策提供证据。真正的问题不是“测没测”,而是:测了哪个性质,覆盖了什么风险,失败时能否定位,成本是否允许持续运行。
1. 测试的五个元素
一条测试至少有:
SUT:System Under Test,被测对象
Input:输入与前置状态
Action:执行动作
Oracle:判断对错的规则
Isolation:与外部环境隔离到什么程度
没有Oracle的脚本只能完成自动操作,无法判断系统行为是否正确。仅产生大量日志而不执行判定,不构成完整测试。
Oracle类型
- Exact Oracle:输出必须等于精确值;
- Schema Oracle:结构、类型、必填字段合法;
- Invariant Oracle:余额不为负、状态不能逆转、权限不能扩大;
- Differential Oracle:新旧实现或两个实现结果一致;
- Metamorphic Oracle:输入按某种变换后,输出满足已知关系;
- Statistical Oracle:成功率、分布或评分达到阈值;
- Human / Rubric Oracle:人工或模型依据评分量表判断。
传统业务逻辑优先使用Exact与Invariant;Agent最终答案常需Rubric和统计指标,但工具参数、状态机和权限仍然可以精确断言。
2. 测试分类维度
| 维度 | 分类 | 它在问什么 |
|---|---|---|
| 是否看内部实现 | 黑盒、白盒、灰盒 | 测试是否利用内部结构 |
| 测试范围 | Unit、Component、Integration、E2E | 一次跨过多少组件 |
| 测试目标 | Functional、Performance、Security、Usability | 验证哪类质量属性 |
| 执行方式 | Manual、Automated、Exploratory | 怎样获得证据 |
| 生命周期 | Smoke、Regression、Acceptance | 在交付流程中承担什么角色 |
例如,“通过HTTP调用真实PostgreSQL的API测试”既可以归类为黑盒或灰盒测试,也可以归类为集成测试、功能测试和自动化回归测试。讨论测试分类时,应先明确采用的分类维度和定义。
3. 测试层次是一组反馈回路
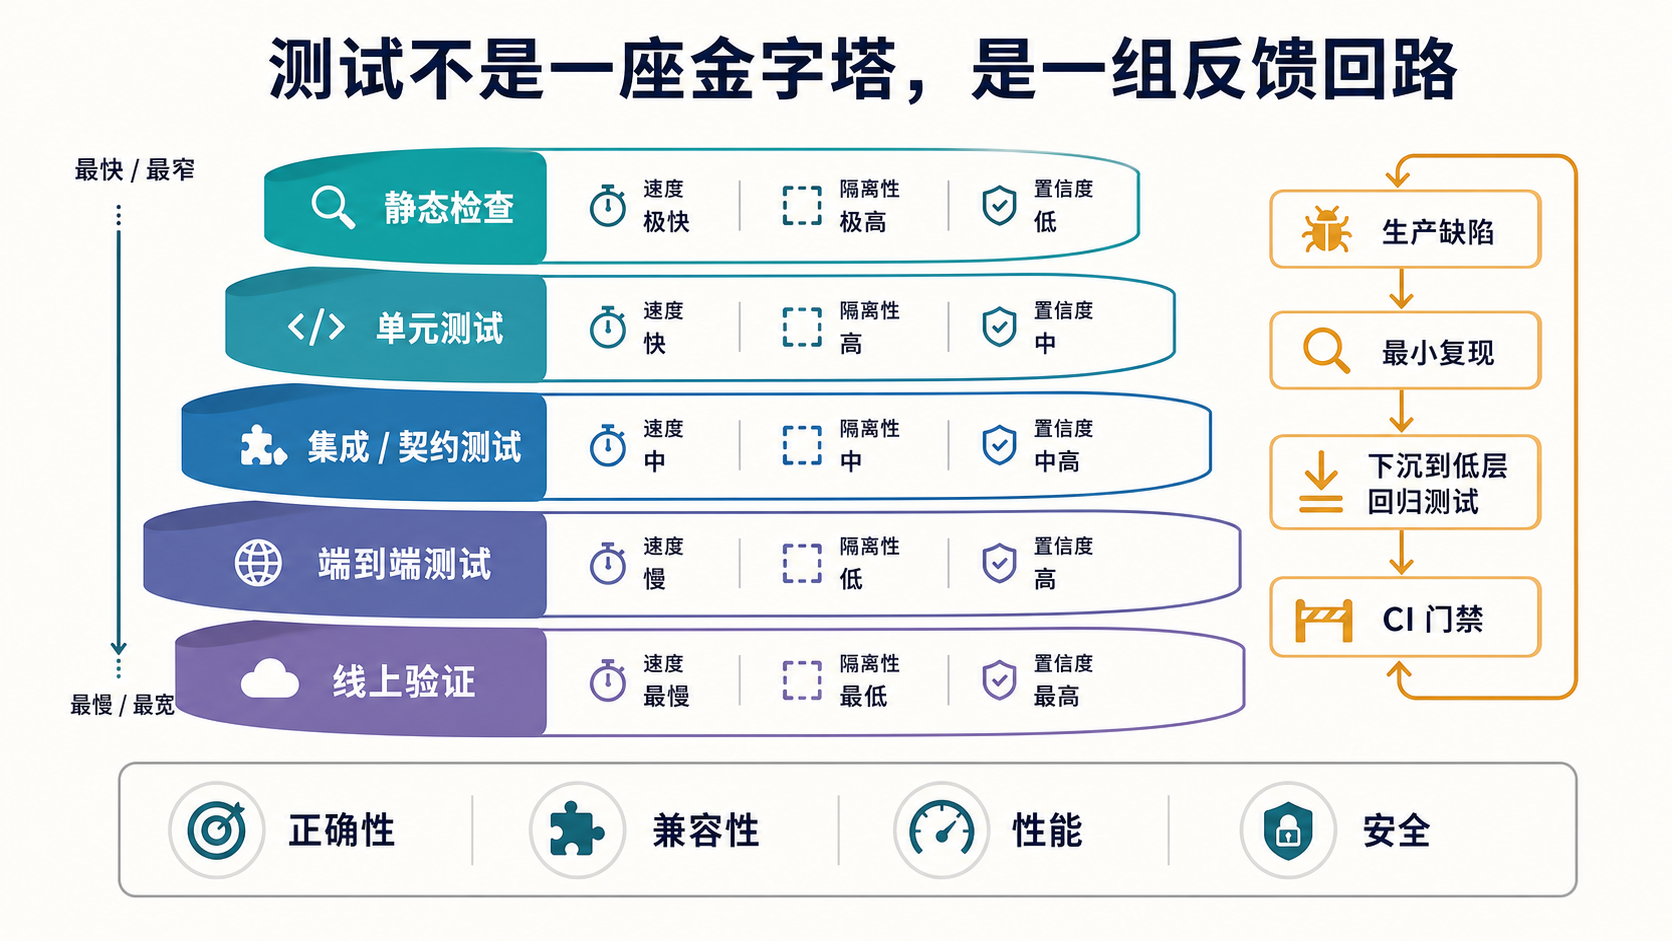
| 层次 | 速度 | 隔离 | 主要发现 |
|---|---|---|---|
| Static | 极快 | 最高 | 类型、格式、已知危险模式 |
| Unit | 快 | 高 | 局部逻辑、边界条件、状态转换 |
| Integration / Contract | 中 | 中 | SQL、序列化、协议、依赖兼容 |
| E2E | 慢 | 低 | 关键用户旅程与系统装配 |
| Production Verification | 持续 | 最低 | 真实流量、长尾环境、容量与漂移 |
Test Pyramid强调反馈成本:低层测试通常更快、更稳定且更容易定位,因此数量更多;高层测试覆盖真实装配,但成本更高,所以集中保护关键路径。它不要求固定比例,也不意味着应当减少有价值的集成测试。
4. 测试用例设计
等价类与边界值
把输入划为行为相同的集合,每类选代表值;边界两侧单独测试。例如分页参数:
非法:page_size < 1
边界:1
常规:20
上边界:100
非法:101
Decision Table
适合多个条件组合:
| 登录 | 有权限 | 需要审批 | 结果 |
|---|---|---|---|
| 否 | 任意 | 任意 | 401 |
| 是 | 否 | 任意 | 403 |
| 是 | 是 | 是 | PENDING_APPROVAL |
| 是 | 是 | 否 | EXECUTE |
Agent Tool Policy尤其适合Decision Table,条件散落在Prompt里则很难穷举。
状态转换
先列合法状态图,再测合法与非法边:
PENDING → RUNNING → SUCCEEDED
                  ↘ FAILED
PENDING / RUNNING → CANCELLING → CANCELLED断言不只看终态,还要验证SUCCEEDED → RUNNING这类逆转被拒绝、重复事件幂等、并发更新有版本约束。
Pairwise与组合爆炸
浏览器、数据库、模型、语言和权限的完整笛卡尔积会产生大量组合。Pairwise使用较少Case覆盖任意两个参数值的组合,以发现常见交互缺陷;高风险组合仍需显式加入,不能仅依赖Pairwise覆盖。
5. 覆盖率的含义与边界
常见覆盖率:Statement、Branch、Condition、Function和Path Coverage。Branch Coverage公式:
假设代码有10个分支,测试走过8个,Branch Coverage是80%。它证明两条分支被执行过,不证明断言正确,也不证明输入边界充分。
100% Statement Coverage可能完全没有验证结果:
func TestTransfer(t *testing.T) {
    _ = Transfer(accountA, accountB, 100) // 跑到了,没断言
}
覆盖率适合发现明显未测试的区域和设置增量门禁,不适合直接作为质量KPI。如果按覆盖率数值考核,团队可能倾向于提高数值而忽视断言质量和风险覆盖。
6. Mutation Testing比覆盖率更接近断言强度
Mutation Tool会对代码做小改动:>变成>=、删除条件、把返回值改成0,再运行测试。测试若没有失败,Mutant存活,说明测试可能没有抓住行为变化。
例如生成100个Mutant,10个与原程序等价,测试杀死72个:
Mutation Testing成本较高,适合核心状态机、计费、权限等高风险模块,不必每天对整个仓库执行。
7. 风险驱动测试
可用一个简单优先级模型:
- :出错概率;
- :损失程度;
- :被多少请求或用户触发。
高风险区域包括资金、副作用、租户隔离、权限、数据迁移和不可逆操作。它们需要更强的Invariant、并发测试、故障注入与人工审查;低风险展示文本可以采用成本更低的验证策略。
8. Agent系统中的概率不确定性
Agent系统有两类变化:
软件不确定性:竞态、超时、依赖失败、Schema变化
模型不确定性:采样、Prompt敏感、语义等价输出、多条合法轨迹
测试策略因此分层:
- 精确测:Parser、Tool Schema、Policy、状态机、预算、幂等、权限;
- 受控测:Fake Model输出固定Action,验证Orchestrator;
- 统计测:真实模型多次采样,计算Task Success、Tool Accuracy、成本;
- 安全测:Prompt Injection、越权Tool、SSRF、敏感数据外泄;
- 线上测:漂移、长尾失败、模型与工具版本变化。
Agent测试最忌讳只断言最终答案包含某句话。答案可能碰巧正确但调用了危险工具,也可能措辞不同却完全正确。需要同时验证Trajectory、Evidence、Side Effect和Final Answer。
9. 缺陷向回归资产的转化
每个生产缺陷走这条闭环:
保存失败输入、环境、版本与Trace
→ 缩小成最小复现
→ 在能抓住它的最低测试层加Case
→ 修复并确认测试先红后绿
→ 加入回归集和CI门禁
→ 监控同类错误是否下降
Agent失败还要保存Model、Prompt、Tool Schema、知识快照和随机参数。若只保存用户Query,在模型或索引版本变化后通常无法准确复现原始运行条件。
10. 面试速答
单元测试越多越好吗
不是。测试也有维护成本。优先覆盖稳定行为、边界和风险;大量复制实现细节的脆弱测试会阻碍重构。
覆盖率多少合适
没有通用数字。看高风险模块、增量覆盖和未覆盖分支;覆盖率配合Mutation、缺陷数据和评审使用。
E2E最真实吗,为什么不全写E2E
它覆盖真实装配,但慢、昂贵、定位差且更易Flaky。边界和异常应尽量在低层验证,E2E保护少数关键旅程。
Agent评测和传统测试有什么区别
传统测试多用确定性Oracle判断Pass/Fail;Agent评测常面对多种合法输出,需要数据集、Rubric、统计和人工校准。但Agent周围的传统软件仍应使用普通测试。