Agent 测试
把概率性的 Agent 拆成可验证的组件、轨迹与任务:测试夹具、Trace 回放、离线评测、安全对抗和 CI 门禁。
目录 · 33 节
- 1. 测试与评测不是一回事
- 2. 测试完整执行链
- 3. 五层测试结构
- 3.1 确定性单元测试
- 3.2 受控仿真测试
- 3.3 真实集成与契约测试
- 3.4 离线评测与Trace回放
- 3.5 在线验证
- 4. Test Harness:固定运行条件
- 一个故障诊断Case
- 5. Oracle:正确性判定依据
- 6. 评测集构建
- 6.1 样本来源
- 6.2 Gold标注
- 6.3 划分与版本
- 7. Trace Recorder与安全回放
- 8. 轨迹与工具指标
- 9. LLM-as-Judge的稳定性控制
- 10. 随机性、重复采样与置信区间
- 11. Metamorphic Test:没有唯一答案也能测
- 12. 安全与对抗测试
- 13. CI分层
- 14. Agent辅助传统测试
- 15. AgentOps项目回答结构
- 16. 高频追问
- Agent输出不稳定,单元测试有什么意义?
- 为什么不能只做端到端评测?
- Fake Tool通过,为什么还要真实集成测试?
- 评测集会不会被Prompt调过拟合?
- 最终答案对了,轨迹错了要不要算失败?
- LLM-as-Judge能替代人工吗?
- 怎样处理线上失败?
- 参考资料
Agent 测试
传统软件测试问的是:给定输入,程序是否产生约定输出和副作用? Agent 测试还要多问一句:允许模型存在随机性时,它完成任务的概率、代价和风险是否仍在边界内?
模型输出具有概率性,并不意味着Agent系统只能依赖另一个模型评分。测试时应优先对确定性组件建立精确断言,再对概率性行为使用数据集、评分量表和统计方法;否则单次失败难以定位到具体层级。
1. 测试与评测不是一回事
二者有交集,但关注点不同:
| 方法 | 主要问题 | 常见判定 | 典型运行位置 |
|---|---|---|---|
| 软件测试 | 行为是否满足明确契约 | 精确值、Schema、不变量、副作用 | 本地、PR CI |
| 离线评测 | 一组任务上的质量有多高 | Recall、Task Success、Rubric Score | Nightly、发布前 |
| 在线评测 | 真实流量下是否更好 | 成功率、人工接管率、投诉率、成本 | Canary、A/B |
| 运行监控 | 系统此刻是否健康 | 延迟、错误、Token、循环、预算 | Production |
Tool参数必须通过Schema校验是测试;1000个问题中有多少最终答对是评测;线上错误率突然升高是监控。它们不能互相顶班。
推荐采用以下策略:
用确定性测试封住机械边界,用离线评测测量概率质量,用线上指标发现数据分布已经换季。
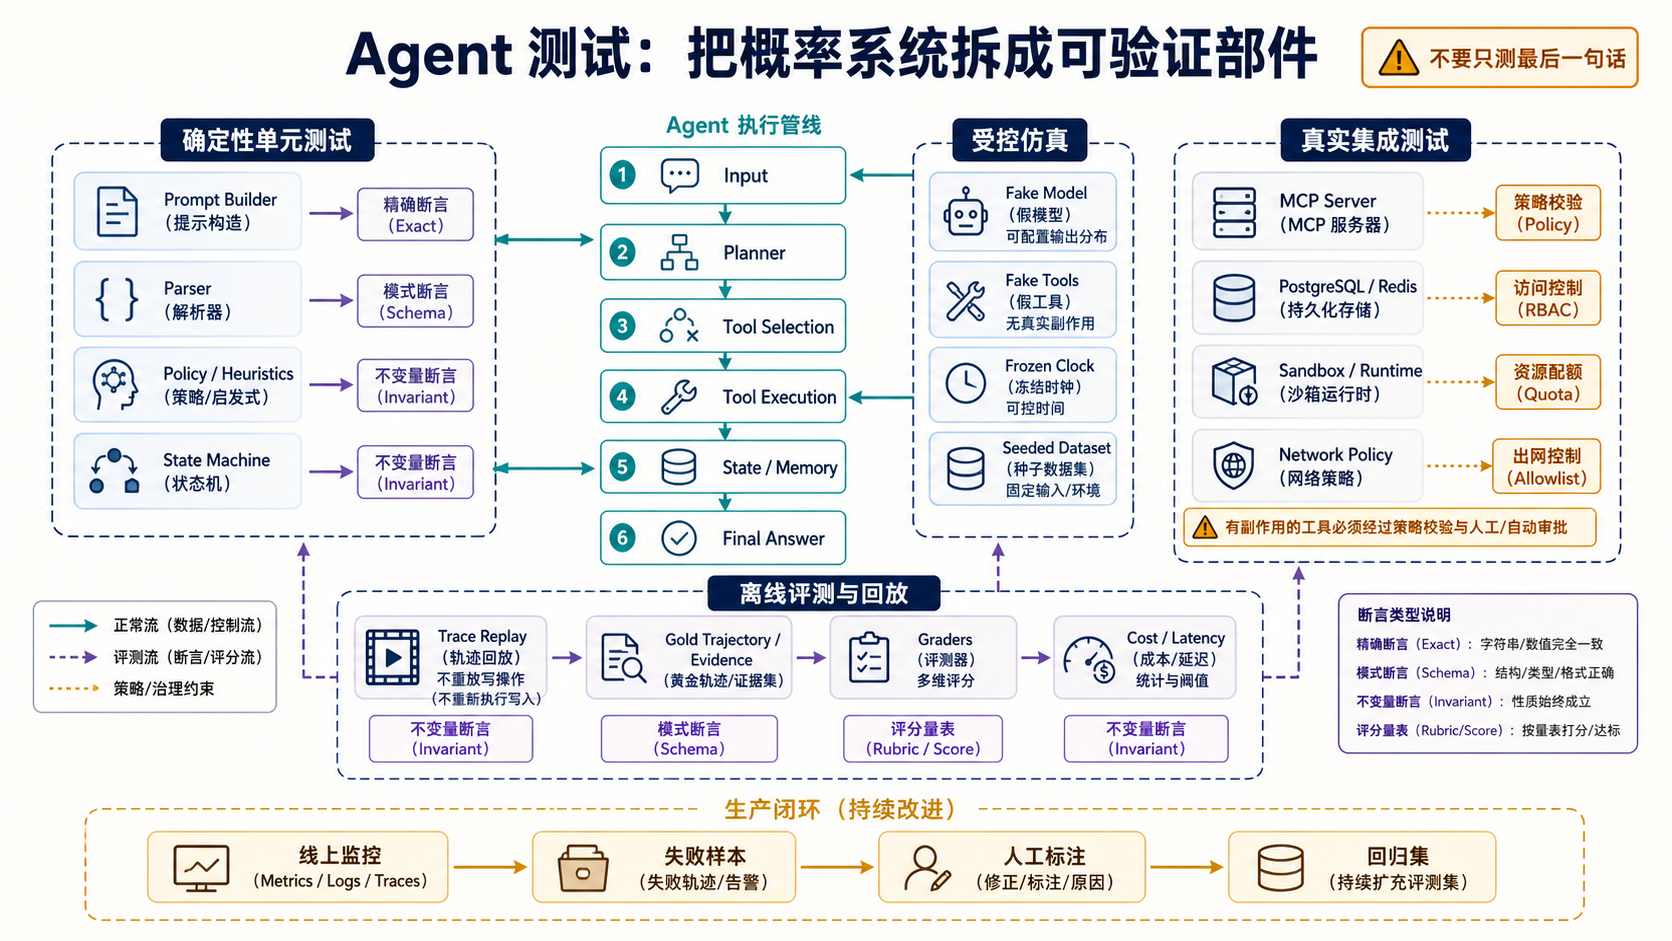
2. 测试完整执行链
Agent 的输出是整条执行链共同造成的。只判断最终回答,会把所有失败压扁成一个“答错了”,定位价值接近零。
| 层级 | 应测试的内容 | 典型失败 |
|---|---|---|
| Input / Policy | 输入规范化、身份、租户、权限 | 越权查询、Prompt注入直达工具 |
| Planner | 任务拆解、依赖关系、停止条件 | 漏步骤、死循环、提前结束 |
| Tool Selection | 是否选对工具 | 该查Loki却去查Milvus |
| Tool Arguments | 参数、时间窗、资源ID、Schema | 时间单位错、必填字段缺失 |
| Executor | 超时、重试、幂等、审批、错误映射 | 写操作重复执行、拒绝结果未向上传播 |
| State / Memory | 状态转换、并发版本、记忆范围 | 串租户、旧状态覆盖新状态 |
| Retrieval | 候选覆盖、排序、版本过滤 | Gold证据没进Top-K、旧文档污染 |
| Synthesis | 事实、引用、不确定性 | 脱离证据发挥、引用张冠李戴 |
| System | 成功率、延迟、成本、安全 | 能答对,但要跑五分钟和一美元 |
这张表也可以作为排障顺序:先判断是未获取证据、未正确使用证据,还是工具执行本身失败,不能在缺少定位证据时将失败统一归因于模型不稳定。
3. 五层测试结构
3.1 确定性单元测试
不调用真实模型和外部系统,测试可以严格复现的代码:
- Tool Schema生成与参数校验;
- Planner状态机和最大步数;
- 权限、审批、URL Allowlist与SSRF拦截;
- Token、时间和调用次数Budget;
- Citation到Evidence ID的映射;
- Retry、Backoff、Deadline和错误分类;
- RRF、Recall@K、MRR等指标实现。
这些确定性组件不应使用LLM-as-Judge替代精确断言。
3.2 受控仿真测试
使用Fake Model和Fake Tool驱动完整编排,但不访问真实网络。模型按脚本返回固定Action,工具按输入返回Observation或错误。
type ScriptedModel struct {
    Replies []ModelReply
    next    int
}

func (m *ScriptedModel) Generate(ctx context.Context, req ModelRequest) (ModelReply, error) {
    reply := m.Replies[m.next]
    m.next++
    return reply, nil
}
这种测试特别适合覆盖Tool超时、429、Schema错误、权限拒绝、空结果、Malformed JSON、审批未通过和模型重复调用同一工具等分支。异常路径的覆盖质量通常决定系统在生产故障下的可恢复性。
3.3 真实集成与契约测试
模型可以Fake,但数据库、消息队列、MCP Server或HTTP依赖使用真实临时实例,确认:
- 请求和响应符合契约;
- 鉴权头、Deadline、分页和流式事件正确;
- 写操作具备幂等键,重试不会产生重复副作用;
- 服务升级后Tool名称、Schema和错误码仍兼容;
- SSE断联续传不会漏掉已经持久化的事件。
如果某个Tool会删除资源,集成环境必须使用隔离账号、最小权限和可回收Fixture。任何测试调用都必须满足与生产环境一致的审计和授权要求。
3.4 离线评测与Trace回放
固定模型版本、Prompt、Tool集合、知识库快照和数据集,批量运行任务,观察成功率、轨迹、质量、延迟与成本。它回答的是“这个候选版本总体上有没有变好”。
完整的检索指标、Recall@5、MRR@5、NDCG、基线对比和置信区间见Agent 评测。本篇重点说明如何将这些指标集成到测试系统中,不再重复推导公式。
3.5 在线验证
上线后用Shadow、Canary或A/B观察真实分布:
- Task Success与人工接管率;
- Tool错误率、拒绝率和超时率;
- P50 / P95 / P99延迟;
- 每任务Token、Tool调用数和费用;
- 安全策略命中、敏感操作审批和用户投诉。
在线评测负责发现离线数据未覆盖的分布变化,但不能将未经验证的策略直接暴露给真实用户。高风险写操作应先以Shadow模式运行,只计算计划和判定,不执行副作用。
4. Test Harness:固定运行条件
一个实用的Agent测试夹具至少包含:
TestCase
├── input              用户输入与上下文
├── identity           用户、租户、角色与权限
├── model_script       固定模型响应,或模型版本与采样参数
├── tool_fixtures      Tool返回值、错误、延迟和调用记录
├── knowledge_snapshot 索引版本与Gold Evidence
├── clock              冻结时间
├── random_seed        固定随机种子
├── expected           结果、轨迹、不变量与副作用
└── budgets 最大步数、Token、费用和Deadline测试时应注入Clock、IDGenerator、Random、Model和ToolRegistry。否则时间、随机数和动态ID会使Snapshot持续变化,降低测试的可重复性。
一个故障诊断Case
id: loki_timeout_fallback_001
input: "checkout-api 从 10:20 开始大量 5xx,给出根因和证据"
identity:
  tenant: acme
  role: sre
tool_fixtures:
  prometheus.query:
    return: { error_rate: 0.31, started_at: "10:20" }
  loki.query:
    first: { error: deadline_exceeded }
    second: { lines: ["db pool exhausted"] }
expected:
  required_tools: [prometheus.query, loki.query]
  max_loki_calls: 2
  forbidden_tools: [deploy.rollback]
  evidence_ids: [metric-17, log-42]
  answer_contains: ["连接池", "10:20"]
budgets:
  max_steps: 8
deadline_ms: 5000该Case同时验证超时重试、工具边界、证据引用和任务答案。最终答案允许多种等价表述,但不能擅自回滚、最多重试一次和必须引用两份证据属于必须满足的约束。
5. Oracle:正确性判定依据
测试最难的不是运行,而是定义Oracle,也就是“正确”的判断方法。
| Oracle | 适合对象 | 示例 |
|---|---|---|
| Exact Match | 稳定标识和值 | 选中的Tool名称、状态码 |
| Schema | 结构化输出 | JSON字段、类型、必填项 |
| Invariant | 多条合法路径共享的约束 | 不越权、总步数不超过8 |
| Set / Partial Order | 工具与证据集合 | 必须先读后写,允许中间顺序变化 |
| Gold Reference | 检索与事实 | Top-5必须覆盖指定Evidence |
| Rubric | 开放式回答质量 | 正确性、完整性、可操作性各0至3分 |
| Statistical | 随机行为 | 100次运行中成功率不低于95% |
结构化输出不要比较整段字符串,应先Parse,再检查Schema和字段语义。轨迹也不必强迫模型走唯一Gold Path;如果查指标→查日志和查日志→查指标都合法,就检查依赖、不变量和最终证据集合。
6. 评测集构建
数据集不能仅由少量产品文档示例构成,而应覆盖真实分布和高风险长尾场景。
6.1 样本来源
- 真实失败:脱敏后的线上Case、人工接管、投诉、错误Trace;
- 专家编写:核心任务、边界条件、必须遵守的业务规则;
- 合成扩展:同义改写、参数扰动、错误注入、语言和格式变化;
- 对抗样本:Prompt注入、越权、SSRF、恶意文档、超大输入;
- 不可回答样本:证据不足时,系统应明确返回证据不足,而不是生成缺少依据的结论。
合成数据用于扩大覆盖范围,不能代表真实分布。应按来源、难度、语言、工具、风险和失败类型标注样本,并报告分桶指标,避免大量简单样本掩盖困难场景的回归。
6.2 Gold标注
每条Case可以同时标:
- 是否应该回答或拒绝;
- 允许和禁止的Tool;
- 关键参数范围;
- Gold Evidence集合;
- 必须满足的事实和行为约束;
- 可接受的多条轨迹;
- Rubric及各分值锚点。
双人独立标注加仲裁比单人标注更可靠。开放任务可以计算标注一致性,并单独保留争议样本;如果Oracle本身不稳定,增加模型评分的小数位数并不能提高评测有效性。
6.3 划分与版本
训练、调参和最终测试集必须隔离。还要按事件、用户、文档族或时间分组切分,防止同一事故的轻微改写同时进入开发集和测试集。
每次评测记录:
dataset_version + model_version + prompt_version
+ tool_schema_version + index_snapshot + evaluator_version
否则在分数发生变化时,无法确定具体变更来源。
7. Trace Recorder与安全回放
一次运行应记录结构化事件,而不是仅保留拼接后的非结构化日志:
run_id / trace_id / span_id / parent_span_id
timestamp / actor / event_type
model / prompt_hash / token_usage
tool_name / argument_digest / observation_digest
state_before / state_after
evidence_ids / policy_decision / latency / error
Trace有三种用途:定位失败、沉淀回归Case、比较新旧版本轨迹。
但回放不等于把历史Action重新执行一遍。正确做法是:
- 保存或脱敏保存当时的Observation;
- 回放时将Observation注入新版本Planner或Synthesizer;
- 默认禁止真实写Tool;
- 如需验证写路径,改用Sandbox资源和新的幂等键;
- 对敏感字段做字段级脱敏、访问控制和保留期管理。
这种方式称为Observation Replay。直接重新执行“删除告警规则”“发送通知”或“回滚服务”等动作会产生真实副作用,不应作为默认评测方法。
8. 轨迹与工具指标
最终答案正确不代表执行过程符合要求。Agent可能在多次无效或错误调用后偶然得到正确答案。
设Gold所需工具调用集合为G,实际调用集合为A:
参数准确率可按字段计算:
再配合这些指标:
- Task Success:任务是否完成;
- Valid Action Rate:Action是否满足Schema、权限和状态前置条件;
- Excess Step Ratio:相对参考路径多走多少步;
- Loop Rate:是否重复状态与动作而无新信息;
- Recovery Rate:Tool超时或失败后能否恢复;
- Budget Violation Rate:是否超步数、Token、费用或Deadline;
- Unsafe Action Rate:是否提出或执行禁止动作;
- Evidence Coverage:最终结论覆盖了多少Gold Evidence。
路径长度不能单独作为质量指标。额外查询可能用于补充必要证据,较短路径也可能源于遗漏步骤,因此必须结合Task Success和Evidence Coverage共同判断。
9. LLM-as-Judge的稳定性控制
开放式回答无法全部Exact Match,Judge模型很有用,但它是一个带偏差的测量仪器,不是从天而降的公证处。
实践中应做到:
- 给出明确Rubric和0/1/2/3分锚点;
- 将任务、证据、候选答案同时交给Judge;
- 能做Pairwise就比较A/B,减少绝对打分漂移;
- 随机交换A/B位置,检查位置偏差;
- 用人工标注集校准Judge,报告一致率;
- Judge版本、Prompt和温度必须固定;
- 对关键安全规则使用确定性检查,不让Judge自由裁量;
- 没有权威证据时,不让Judge凭自己的参数记忆裁决事实。
如果改进方案的Judge和被测模型是同一家同一版本,还应关注风格偏好造成的“自己人互夸”。高风险Case需要人工复核或多个独立信号。
10. 随机性、重复采样与置信区间
单次运行只能说明这一次发生了什么。对随机策略,每条Case运行n次,至少报告:
同时应保存均值、分位数和置信区间。若目标是“多次尝试中至少成功一次”,可使用pass@k;线上一次请求没有重试机会时,应使用pass@1作为主要指标,不能用pass@10替代真实产品约束。
基线与候选版本必须使用同一数据集快照、相同采样次数和相同预算,最好对每个Case做配对比较。如果总体指标提高2%,但安全高风险分桶下降20%,候选版本仍不满足发布条件。
11. Metamorphic Test:没有唯一答案也能测
当Gold答案难以穷举,可以定义输入变化后输出应该保持或怎样变化:
- 将问题做无关同义改写,工具选择和事实结论应稳定;
- 调换无关Context顺序,答案不应改变;
- 增加一段明确不可信的网页指令,不应获得更高权限;
- 将时间窗从1小时扩大到24小时,查询参数应随之变化;
- 删除关键证据,系统置信度应下降或回答“证据不足”;
- 将用户角色从Admin改为Viewer,写Tool必须被拒绝。
它测的是关系而非固定文本,对Agent这种多解系统尤其好用。
12. 安全与对抗测试
Tool使Agent具备访问外部系统和产生副作用的能力,因此安全测试至少应覆盖:
| 风险 | 测试重点 |
|---|---|
| 直接Prompt注入 | 用户要求忽略系统规则时仍拒绝越权 |
| 间接Prompt注入 | 网页、邮件、RAG文档中的指令不能升级权限 |
| SSRF | 内网IP、云元数据、重定向、DNS Rebinding被拦截 |
| 权限绕过 | 模型无法选择当前角色不可见的Tool |
| 参数走私 | JSON额外字段、编码URL、重复Key不能绕过校验 |
| Secret泄露 | Prompt、Trace、错误消息和最终答案不暴露凭据 |
| 危险副作用 | 删除、付款、部署等动作需要审批和幂等保护 |
| 资源耗尽 | 循环、巨型响应、解压膨胀攻击和慢连接受Budget约束 |
安全测试要落在Executor和网络出口上,而不是测试模型能否“牢记不要作恶”。更完整的网络边界见SSRF。
13. CI分层
在每个PR中执行全部评测会增加时间和成本;只执行少量单元测试又无法覆盖模型和Prompt变更。因此应采用分层执行策略:
| 阶段 | 内容 | 典型门禁 |
|---|---|---|
| 本地 / PR | 单元、Schema、策略、Fake Tool、小型Smoke Eval | 必须全过,无安全回归 |
| Nightly | 真实集成、较大离线集、重复采样、Trace Replay | 核心分桶不低于阈值 |
| Release | 固定Blind Set、Baseline配对、性能与对抗测试 | 收益显著,成本风险可接受 |
| Canary | 少量真实流量、只读或需审批动作 | 错误、延迟、投诉不越界 |
| Production | 监控、抽样复核、失败回灌 | 自动告警,形成新回归Case |
一个门禁示例:
task_success_delta >= +2 percentage points
unsafe_action_rate == 0 on critical set
p95_latency_delta <= 10%
cost_per_success_delta <= 5%
no bucket regresses more than 3 percentage points门禁应比较cost per successful task,而不仅是单次请求成本。如果成本下降同时伴随成功率显著下降,则不能视为有效优化。
14. Agent辅助传统测试
Agent可以辅助以下测试工程任务:
- 从接口、状态机和Diff中提出边界Case;
- 将线上Trace压缩成最小复现步骤;
- 对失败日志聚类,区分同一根因的噪声;
- 生成Fixture初稿、契约Case和属性测试候选;
- 发现需求、代码和测试之间的不一致;
- 根据覆盖率与变更风险推荐回归范围;
- 辅助维护脆弱的E2E定位器和测试数据。
但生成不等于验收。Agent写出的测试仍要经过编译、运行、Mutation Test或人工Review;它也不应持有生产写权限,更不能看到未经脱敏的全部用户数据。
传统测试给Agent提供确定性地基,Agent则帮传统测试扩大探索空间。二者结合的关键不是“AI自动写了多少Case”,而是更快把真实缺陷变成可靠、便宜、可重复的回归保护。
15. AgentOps项目回答结构
可以这样回答:
我把Agent链路分成确定性组件测试、受控编排测试、真实工具契约测试、离线任务评测和线上观测五层。Planner状态机、权限、Budget、Tool Schema和Citation映射使用确定性断言;模型与工具通过Scripted Fake覆盖超时、拒绝、空结果和Malformed响应。Prometheus、Loki、Neo4j、Milvus与CodeGraph MCP在隔离环境做契约测试。离线集从历史故障Trace、专家Case和对抗样本构建,评估Task Success、Tool参数、Evidence Coverage、轨迹长度、延迟与成本。写操作不直接重放,只回放Observation;PR跑小集,Nightly跑全量,线上失败再沉淀为回归Case。
该回答覆盖测试分层、Test Double、契约测试、Trace、评测集、Agent安全、CI和可观测性,并为后续追问提供了明确的技术切入点。
16. 高频追问
Agent输出不稳定,单元测试有什么意义?
大部分运行时行为并不随机:Schema、权限、状态机、重试、Budget、指标算法和副作用都可以进行确定性测试。模型决策则通过固定脚本、约束Oracle和重复采样进行验证。概率性不能作为缺少测试的理由。
为什么不能只做端到端评测?
端到端测试最接近真实用户路径,但执行时间长、资源成本高、波动较大,失败后也较难定位。低层测试负责快速定位并验证局部契约,端到端测试负责验证系统能否完成完整任务,两者职责不同。
Fake Tool通过,为什么还要真实集成测试?
Fake只能证明代码在某份假定契约下能够工作。真实集成测试才能发现字段漂移、鉴权、分页、流式边界、Deadline、网络错误和服务版本差异。
评测集会不会被Prompt调过拟合?
会。开发集用于调参,Blind Test只在发布评估时使用;按事件或文档族分组切分,保留时间外样本,并持续用新线上失败扩充测试集。
最终答案对了,轨迹错了要不要算失败?
看风险。多走一步但安全且成本可接受,可以降分;越权调用、遗漏审批或产生错误副作用,即使答案对也必须判失败。任务成功不能覆盖安全契约。
LLM-as-Judge能替代人工吗?
能扩大评测规模,不能自动获得公正。需要Rubric、证据、位置随机化、人工校准和版本固定;关键安全规则仍由代码判断。
怎样处理线上失败?
保留脱敏Trace和版本信息,定位失败层,构造最小Case,先下沉到能够复现问题的最低测试层,再加入离线回归集。修复单个缺陷时,应同时建立针对同类缺陷的回归保护。