可观测性
Metrics、Logs、Traces与Grafana系列入口:从信号模型、采集存储和关联排障,到Agent链路与测试回灌。
可观测性
监控用于判断已知指标是否越过阈值;可观测性要求系统产生足够的内部信号,使运维人员能够根据外部输出分析未预先定义的问题。部署Grafana只是实现手段之一,不能替代埋点设计、信号关联和故障分析流程。
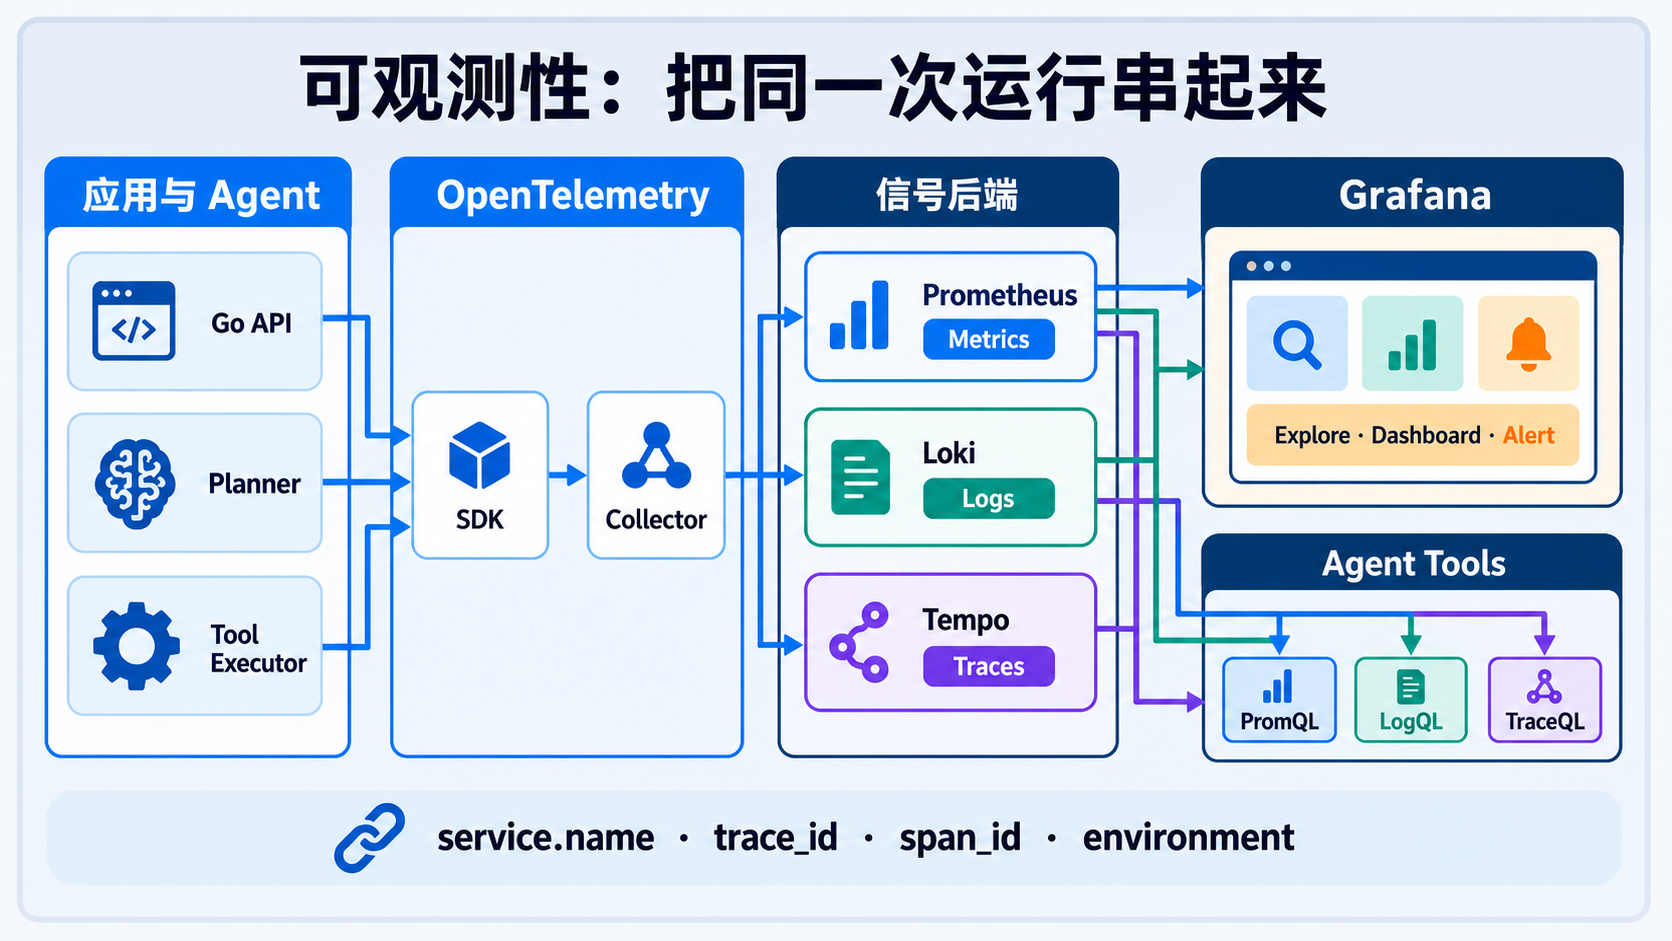
整套链路分成五层:
业务与Agent埋点
→ OpenTelemetry SDK / Collector采集、处理和导出
→ Prometheus / Loki / Tempo分别保存指标、日志和Trace
→ Grafana做查询、关联、看板和告警
→ 事故Trace沉淀为回归Case与评测数据
注意两个常被面试追着打的边界:
- Grafana主要是查询和可视化入口,不是Prometheus、Loki、Tempo的替代品;
- Agent自动取证应调用受限的PromQL、LogQL和Trace查询Tool,不需要模仿人类在Grafana里点鼠标。
Metrics与Prometheus
Counter、Gauge、Histogram和Summary怎样选;Prometheus标签为什么不能塞user_id和trace_id;如何用PromQL计算QPS、错误率与P99,以及RED、USE、SLO和告警门禁怎样落地。
Logs与Loki
结构化日志、Event Schema、日志级别、Loki的Stream与Label、LogQL查询、Structured Metadata、脱敏和保留策略。重点解释为什么日志可以很丰富,但索引标签必须克制。
Traces与OpenTelemetry
Trace、Span、Context Propagation、Span Event与Span Link;OpenTelemetry SDK、Collector、采样与Tempo后端;再为Planner、Model、Tool、Retrieval和Synthesizer设计Agent Span。
Grafana与信号关联
Dashboard、Explore、Data Source、Alerting、Provisioning分别负责什么;如何从错误率曲线定位慢Trace,再由trace_id关联相关日志,最终形成可复查的RCA证据链。
三种信号不是三份重复数据
| 信号 | 最擅长回答 | 代价与限制 |
|---|---|---|
| Metrics | 是否异常、影响多大、何时开始 | 聚合后缺少单次请求细节 |
| Traces | 哪条请求、哪一步、依赖关系怎样 | 体量大,通常需要采样 |
| Logs | 具体发生了什么、错误上下文是什么 | 搜索成本高,结构和隐私治理困难 |
典型排障路线是:
Metrics发现checkout-api的5xx和P99同时升高
→ 由Exemplar或时间窗进入异常Trace
→ 找到db.query Span占用1.8秒
→ 用trace_id过滤Loki日志
→ 看到db pool exhausted
→ 形成“连接池耗尽→排队→超时”的证据链
这组文章最终服务于一个目标:让每条告警都有明确的排障入口,让每个结论都能关联原始证据,并将每次事故沉淀为测试与评测资产。