RAG
从索引构建到 BM25、Dense Retrieval、ANN、融合、重排、GraphRAG、上下文构造与评测,完整梳理 RAG 的算法和工程边界。
目录 · 29 节
- 1. 完整数据路径
- 2. 文档摄取与Chunking
- 2.1 Chunk的数据模型
- 2.2 固定窗口、结构切分与父子块
- 3. BM25
- 3.1 基本公式
- 3.2 参数含义
- 3.3 分词与字段权重
- 4. Dense Retrieval
- 4.1 Dense擅长与不擅长的内容
- 4.2 Embedding训练目标
- 5. ANN:向量库怎样避免全量扫描
- 5.1 HNSW
- 5.2 IVF
- 5.3 查询改写与扩展
- 6. Hybrid Retrieval
- 6.1 候选集合
- 6.2 分数归一化与加权
- 6.3 Reciprocal Rank Fusion
- 6.4 MMR去冗余
- 7. Cross-Encoder Rerank
- 8. Neo4j与Milvus
- 8.1 图检索过程
- 8.2 双索引版本一致性
- 9. Context构造
- 10. 生成、引用与拒答
- 11. 分层评测
- 12. 项目回答
- 13. 高频追问
RAG
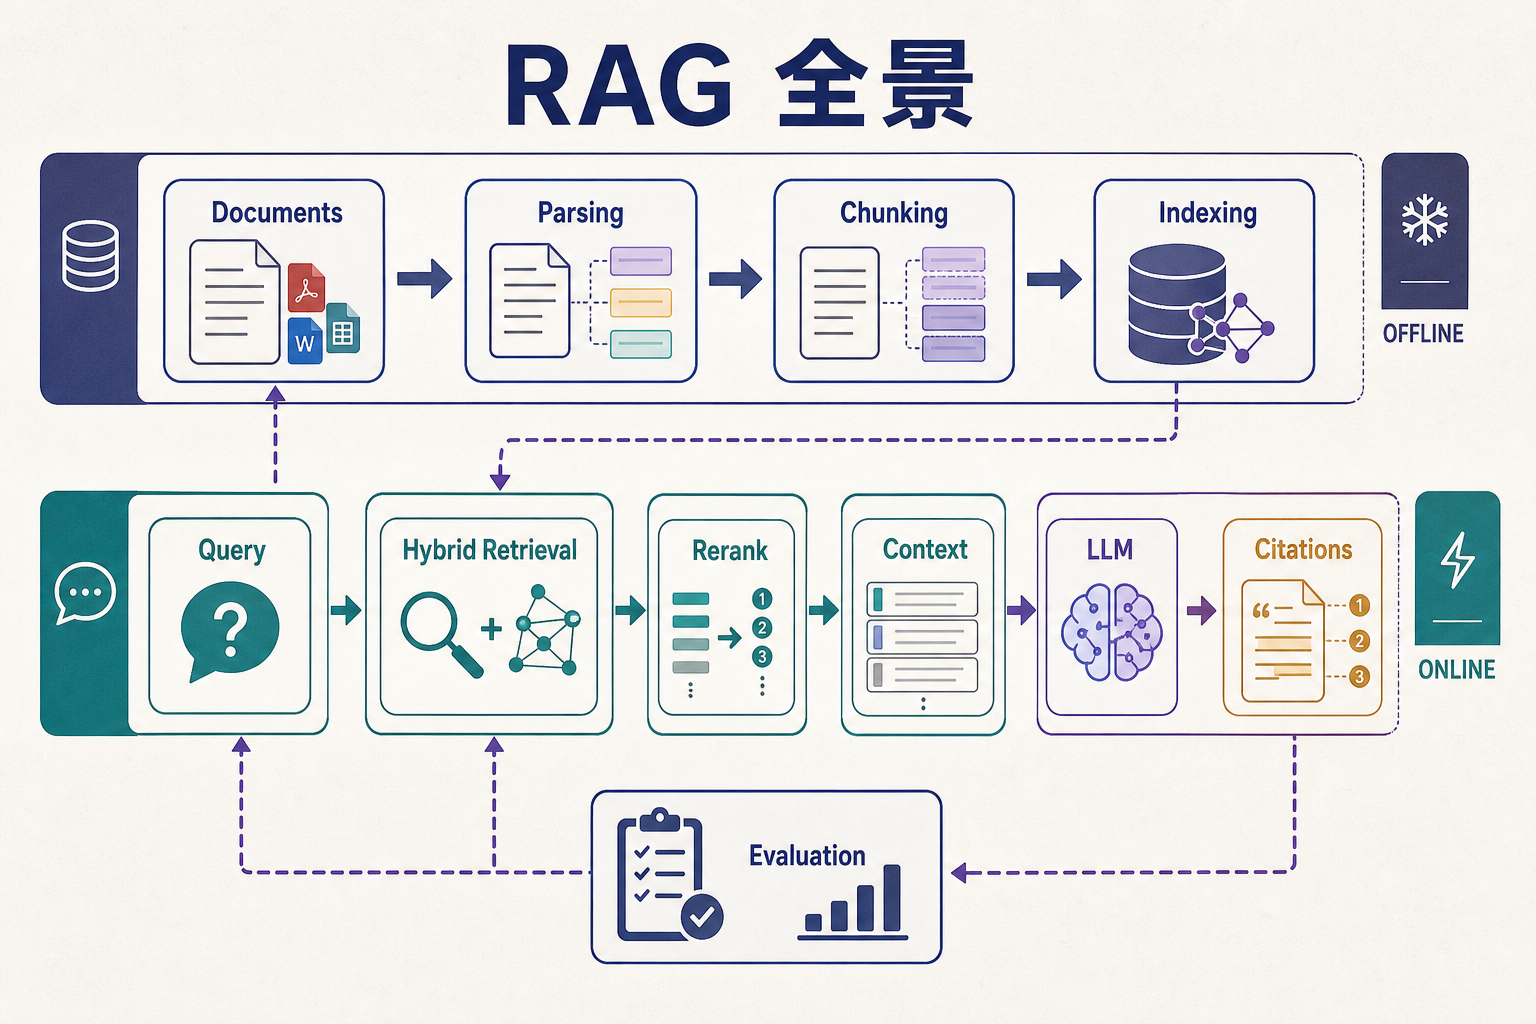
RAG的目标不是简单地向模型附加若干文本片段,而是在有限的延迟和Token预算内,从权限正确、版本一致的知识中检索足以回答问题的证据,并使答案能够追溯到这些证据。完整链路包括摄取、索引、召回、融合、重排、上下文构造、生成、引用校验和评测。
1. 完整数据路径
Documents
→ Parse / Normalize / Deduplicate
→ Structure-aware Chunking
→ Sparse Index + Dense Index + Metadata / ACL Index
→ Query Normalize / Rewrite / Route
→ BM25 + ANN + Graph Recall
→ Filter / Deduplicate / Fusion
→ Cross-Encoder Rerank
→ Context Selection / Token Budget
→ Grounded Generation / Citation / Refusal
→ Trace / Offline Evaluation / Online Feedback
离线阶段决定知识是否可检索、可追溯;在线阶段决定证据是否能够被召回、排序并送入模型;评测阶段负责把失败定位到Retrieval、Rerank、Context或Generation,而不是把所有错误归给最后一次LLM调用。
2. 文档摄取与Chunking
2.1 Chunk的数据模型
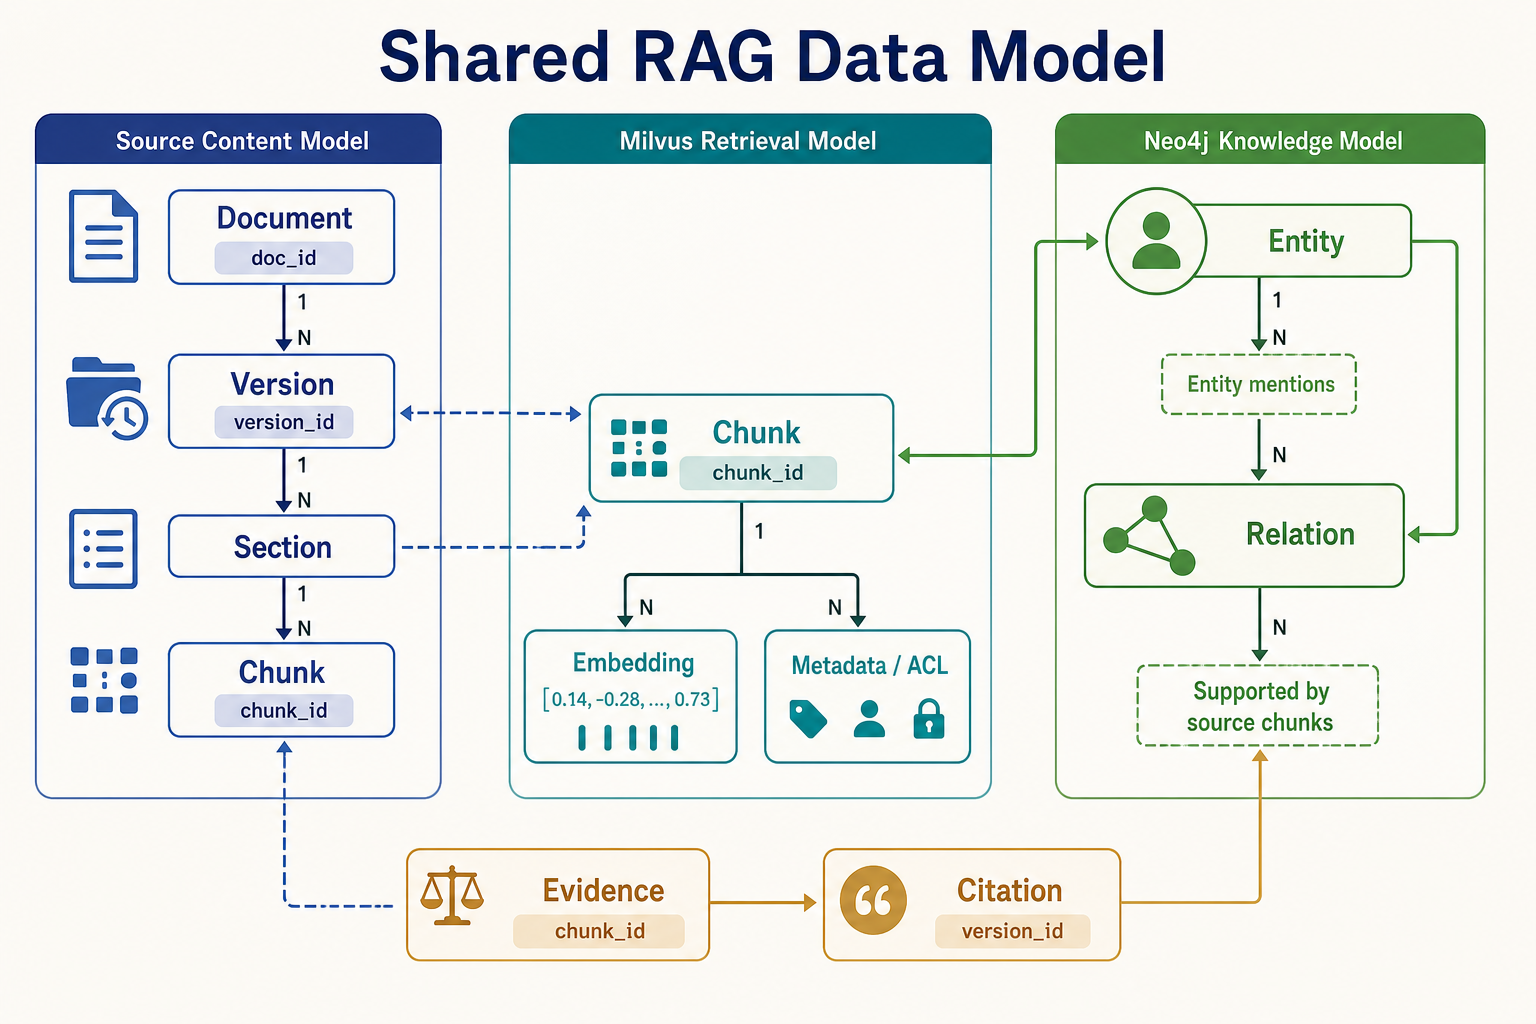
Chunk不应只有text和embedding。至少保存:
doc_id, version_id, chunk_id
text, title_path, page_or_offset
parent_chunk_id, prev_chunk_id, next_chunk_id
tenant_id, acl, source_uri
parser_version, chunker_version, embedding_model
content_hash, created_at, statusversion_id保证旧回答可复现;chunk_id连接稀疏索引、向量索引、图谱和Citation;ACL必须在检索阶段执行,不能等模型已经看到内容后再从答案里删除。
2.2 固定窗口、结构切分与父子块
设Token序列长度为L,Chunk大小为c,Overlap为o,则步长为:
增大c能够保留更多上下文,但每个向量包含的主题更杂,匹配粒度下降,送入模型的Token成本也上升。减小c有利于定位,但容易把定义、条件、表格行和结论拆开。Overlap缓解边界截断,却会制造重复候选和索引膨胀。
结构感知切分优先沿标题、段落、列表、代码块和表格边界切。父子块策略使用小块参与检索,命中后取父块或相邻块供模型阅读,在召回粒度与上下文完整性之间折中。
比较Chunk策略时,需要固定Embedding模型、索引参数和候选数,在包含跨段落、跨标题、表格和代码的问题集上比较:
- Evidence Recall@K;
- 完整证据覆盖率;
- 平均候选Token和最终Context Token;
- 重复率;
- Citation定位误差;
- 索引体积和P95延迟。
3. BM25
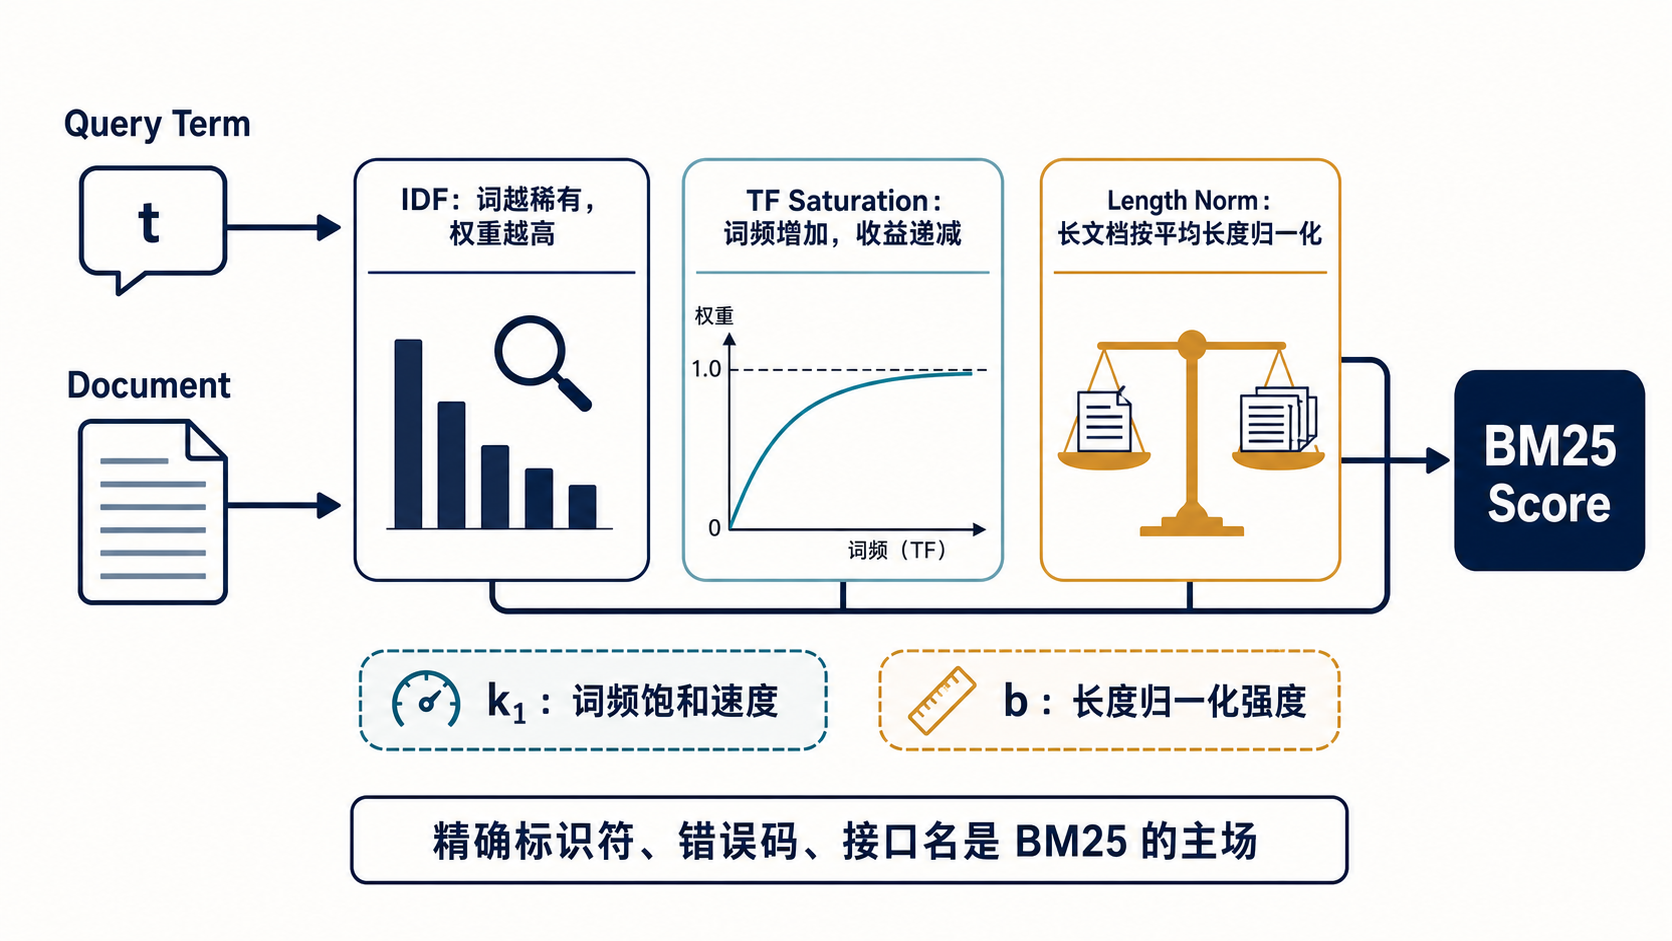
BM25是基于词项匹配的概率排序函数。它结合逆文档频率、词频饱和和文档长度归一化,适合错误码、API名称、配置项、类名和专有名词等词面信号。
3.1 基本公式
设查询为q,文档为d,语料文档数为N;词项t出现在n_t篇文档中;f(t,d)是词项在文档中的频次;|d|是文档长度;avgdl是平均文档长度。常见BM25写法为:
| 符号 | 含义 | 直觉 |
|---|---|---|
| 语料中的文档总数 | 统计一共看过多少篇文档 | |
| 包含词项的文档数 | 越小,说明这个词越稀有 | |
| 在文档中的出现次数 | 命中次数,但收益会逐渐饱和 | |
| 文档的长度 | 长文更可能偶然包含查询词,需要校正 | |
| 语料平均文档长度 | 文档长度的比较基准 | |
| 词频饱和参数 | 控制重复命中还能加多少分 | |
| 长度归一化参数 | 控制对长文的惩罚强度 |
拿一个词项手算。设、、、、、、:
这里的只是词项对文档的贡献。查询包含多个词时,需要对每个查询词的贡献求和。是长度修正项,是经过饱和处理的词频贡献;它们不是新的模型参数,仅用于拆分和说明计算过程。
不同搜索引擎对IDF、Query Term Frequency和负IDF有实现差异,面试时应先说明采用的版本,不要把某个库的实现当作唯一数学定义。
3.2 参数含义
k1控制词频饱和。k1越大,重复出现同一词仍会继续增加分数;k1=0时接近只关心是否出现。b控制长度归一化。b=1完全按相对文档长度归一化,b=0不做长度修正。- 常见起点是
k1≈1.2~2.0、b≈0.75,但必须在自己的语料和验证集上调参。
词频部分会饱和。例如在其他条件固定时,词项从1次增加到2次的收益,通常大于从20次增加到21次的收益。这避免堆叠关键词无限抬高分数。
3.3 分词与字段权重
中文BM25首先受分词影响。错误码ERR_CONN_RESET、驼峰接口名、路径和版本号若被错误切分,公式正确也召回不到。工程上通常需要:
- 中文词典与领域词典;
- 保留错误码、URL、类名、数字和连字符Token;
- 标题、正文、标签分字段建索引;
- 使用BM25F或字段Boost,使标题命中权重高于普通正文;
- 对停用词、同义词和大小写进行可控处理。
4. Dense Retrieval
Dense Retrieval使用Encoder把查询和文档映射到向量空间:
其中和分别是查询与文档的Embedding向量;上标表示转置,因此就是两向量的点积,表示L2范数。
常见相似度函数:
若向量已做L2归一化,Cosine排序与Inner Product排序等价:
索引Metric必须与Embedding模型训练目标一致。把按Cosine训练的模型直接用未归一化Inner Product检索,向量模长会额外影响排序。
4.1 Dense擅长与不擅长的内容
Dense擅长同义改写、自然语言描述和语义近似。例如“连接池被耗尽”和“无法取得数据库连接”可能没有共同词项,但语义接近。它容易漏掉罕见错误码、精确数字、版本号和短标识符,也可能召回语义相似但事实无关的段落。
4.2 Embedding训练目标
双塔检索常使用对比学习。对一个正样本d+和一组负样本d-,可使用InfoNCE形式:
是正样本文档,是同一批候选文档集合,是相似度函数,是Temperature。越小,Softmax越强调最相似样本之间的差异。Hard Negative应当与查询表面或语义接近但不包含正确证据;负样本太简单,模型学不到精细边界;把潜在相关文档误标成负样本,则会产生False Negative。
5. ANN:向量库怎样避免全量扫描
对百万级向量逐个计算相似度成本过高,Milvus等向量库使用Approximate Nearest Neighbor索引,在Recall、Latency和Memory之间取舍。
5.1 HNSW
HNSW构造多层邻接图。高层节点少,用于远距离导航;底层节点密,用于局部精搜。查询从最高层入口开始贪心移动到更近邻居,再逐层下降;到底层后维护候选队列扩展邻居。
核心参数:
M:每个节点的邻接边规模。增大后Recall通常提高,内存和构建成本增加。efConstruction:建图时搜索宽度。越大,图质量和构建成本越高。efSearch:查询候选宽度。越大,Recall和延迟通常同时上升。
5.2 IVF
IVF先用聚类中心把向量分到nlist个倒排桶。查询时找到最近的nprobe个中心,只扫描这些桶:
Build: vector → nearest centroid → inverted list
Query: query → top nprobe centroids → scan candidate listsnprobe越大越接近全量搜索,Recall提高、延迟增加。IVF_PQ进一步用Product Quantization压缩向量,降低内存与I/O,但会引入量化误差。
选择索引不能只看P50。应在固定数据快照上画Recall@K - P95 Latency - Memory曲线,再决定HNSW或IVF参数。
5.3 查询改写与扩展
原始Query可能包含指代、省略、口语和多个子问题。常见处理包括:
- Query Normalization:统一大小写、错误码格式、时间与服务别名;
- Query Decomposition:将多约束问题拆为可独立检索的子查询;
- Multi-query:生成多个语义改写,分别召回后融合;
- Entity Linking:将服务别名映射到稳定Entity ID,供图检索与Metadata Filter使用;
- HyDE:先生成假设性答案或文档,再对其Embedding进行检索。
Multi-query可提高Recall,但会线性增加召回成本,并引入重复候选。HyDE在领域知识不足时可能把模型假设带入检索方向,因此只能用生成文本构造检索向量,不能把假设文本作为Evidence。所有改写都应与原始Query一起写入Trace,并在评测中做单独消融。
6. Hybrid Retrieval
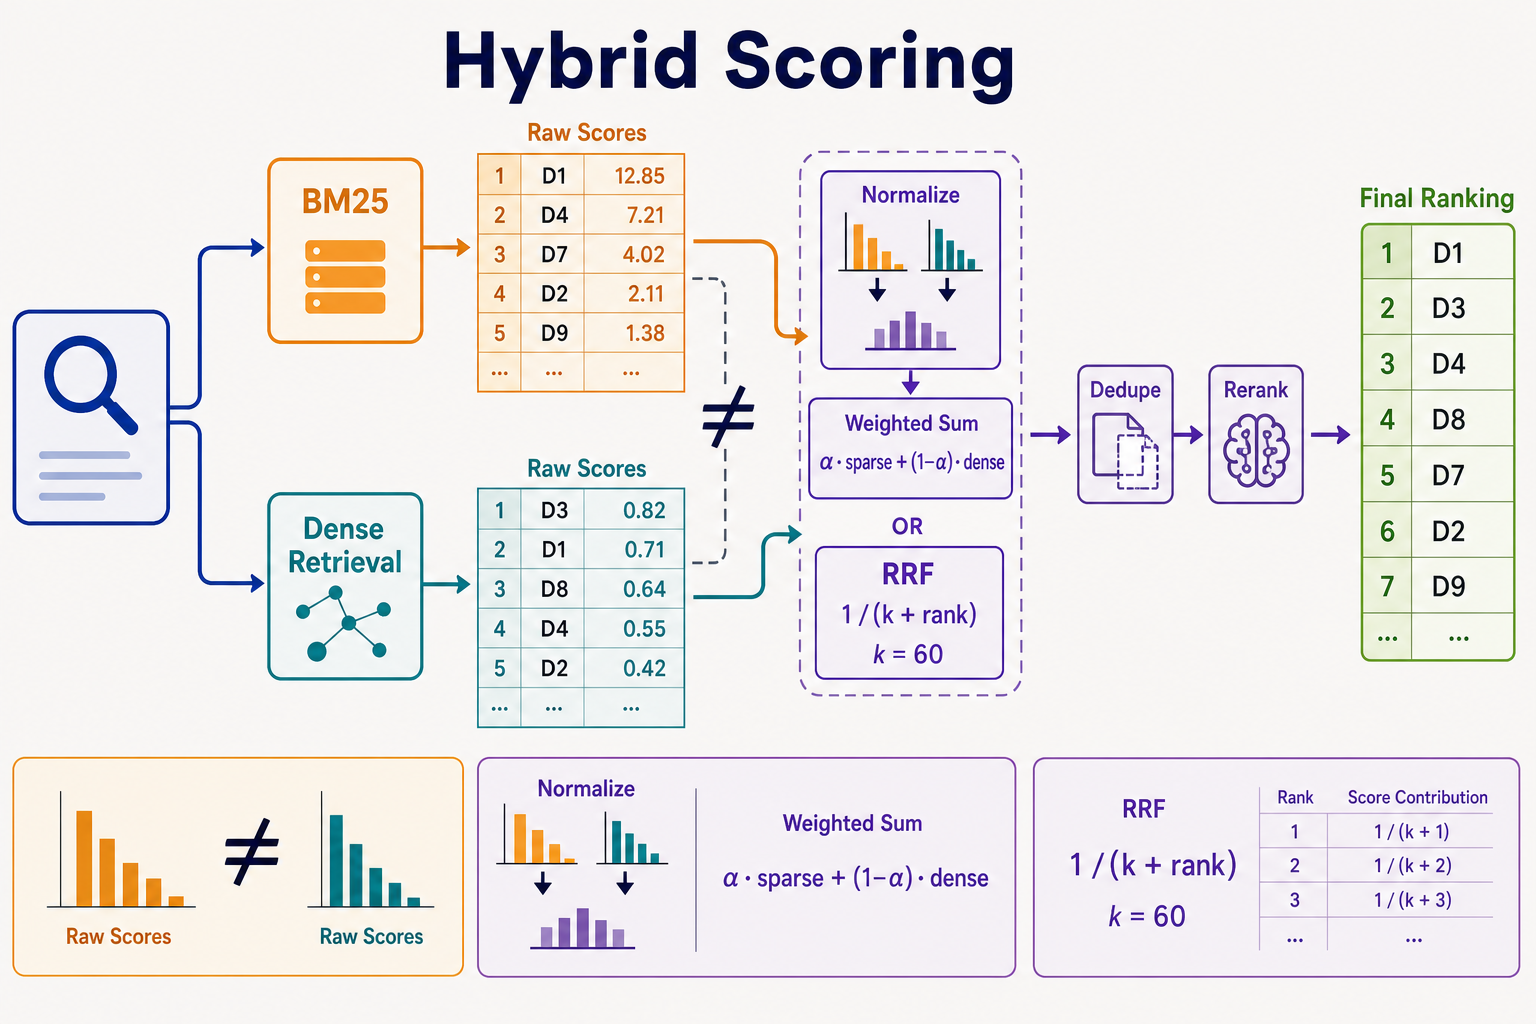
BM25与Dense互补:前者捕获词面精确性,后者捕获语义相似性。混合检索需要先分别产生候选,再解决分数不可比、重复项和过滤问题。
6.1 候选集合
去重键通常是chunk_id。如果父子块或相邻块最终映射到同一父文档,还需要文档级或段落级聚合,避免最终Context被同一段内容占满。
ACL、Tenant和Version过滤应尽可能在召回前执行。向量索引若只能Post-filter,过滤后候选可能不足,需要增大召回数或使用支持Filtered ANN的索引。
6.2 分数归一化与加权
原始BM25可能是12.8,Cosine可能是0.82,二者不能直接相加。常见归一化包括:
然后计算:
其中、和是校准到可比较尺度后的三路分数;、、是三路权重。令不是数学要求,但有利于解释。Min-Max若只在当前Top-N内计算,会受极端值和候选集合变化影响;Z-score假设分布相对稳定;Sigmoid或Platt-style Calibration需要带相关性标签的校准集,但跨查询通常更可控。
缺失于某一路的文档不能随意填该路最小分。常见做法是填0、使用缺失指示变量,或只对实际出现的路计算并额外加入Coverage特征,具体选择要通过验证集确认。
6.3 Reciprocal Rank Fusion
RRF忽略原始分数,只使用各路排名:
若文档未出现在某一路Top-N中,该路贡献为0。假设k_rrf=60:
| 文档 | BM25排名 | Dense排名 | RRF分数 |
|---|---|---|---|
| A | 1 | 10 | 1/61 + 1/70 ≈ 0.03068 |
| B | 3 | 3 | 1/63 + 1/63 ≈ 0.03175 |
| C | 未出现 | 1 | 1/61 ≈ 0.01639 |
B虽然没有任何一路排第一,但两路都稳定靠前,因此融合后超过A。k_rrf越大,头部名次差异被压平;越小,第一名优势更明显。60只是常见起点,需要在Dev集调参。
RRF稳定、无需校准,但会丢弃原始分数间距:第一名比第二名高很多和只高一点,在RRF中差异相同。需要利用置信强弱时,使用校准分数或Learning-to-Rank。
6.4 MMR去冗余
在候选高度重复时,可以使用Maximal Marginal Relevance兼顾相关性与多样性:
每轮选择MMR最高的候选。λ越大越重相关性,越小越重多样性。MMR适合减少同一段落的重复变体,但若问题确实需要同一文档中的连续证据,过强去重会损害完整性。
7. Cross-Encoder Rerank
双塔提前分别计算e_q和e_d,速度快但交互有限;Cross-Encoder把[query, document]一起输入Transformer,输出相关性分数:
它能够进行细粒度Token交互,通常排序质量更高,但每个Query-Document对都要完整前向计算,因此只用于几十到几百个召回候选,不能直接扫全库。
训练可使用Pointwise分类/回归、Pairwise Margin Loss或Listwise Loss。线上应记录Rerank前后Gold Evidence排名变化、P95延迟和Batch吞吐,不能只汇报最终答案主观变好。
8. Neo4j与Milvus
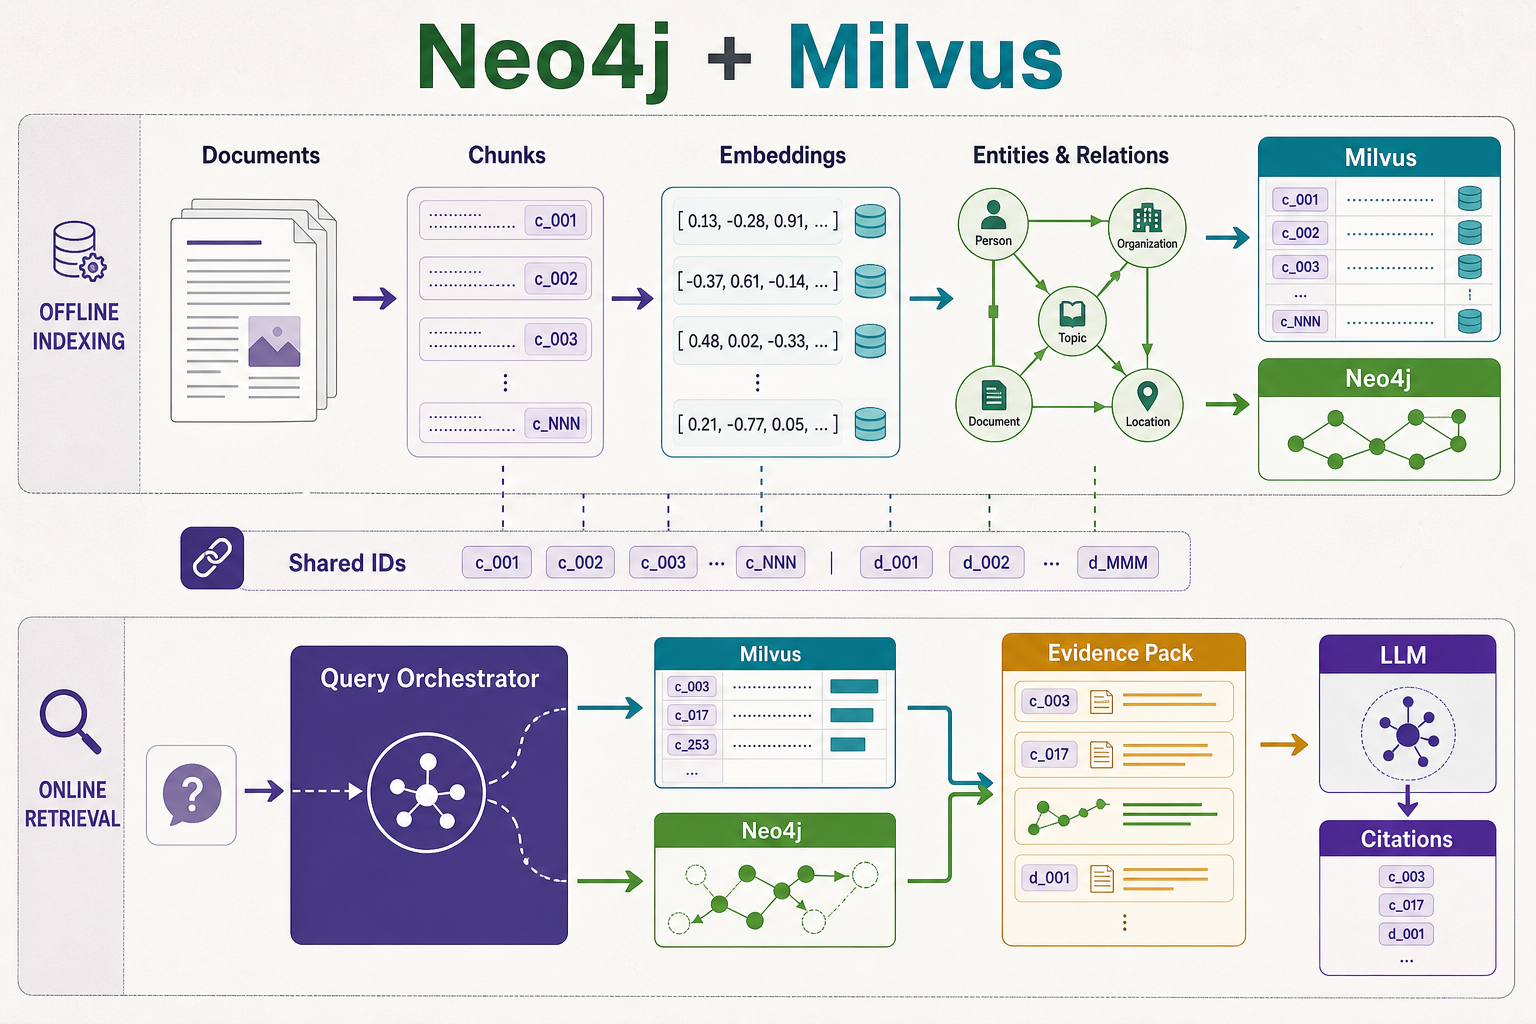
Milvus保存Chunk Embedding与检索Payload,回答“哪些文本在语义上相似”;Neo4j保存实体、关系和来源,回答“哪些对象通过什么关系连接”。
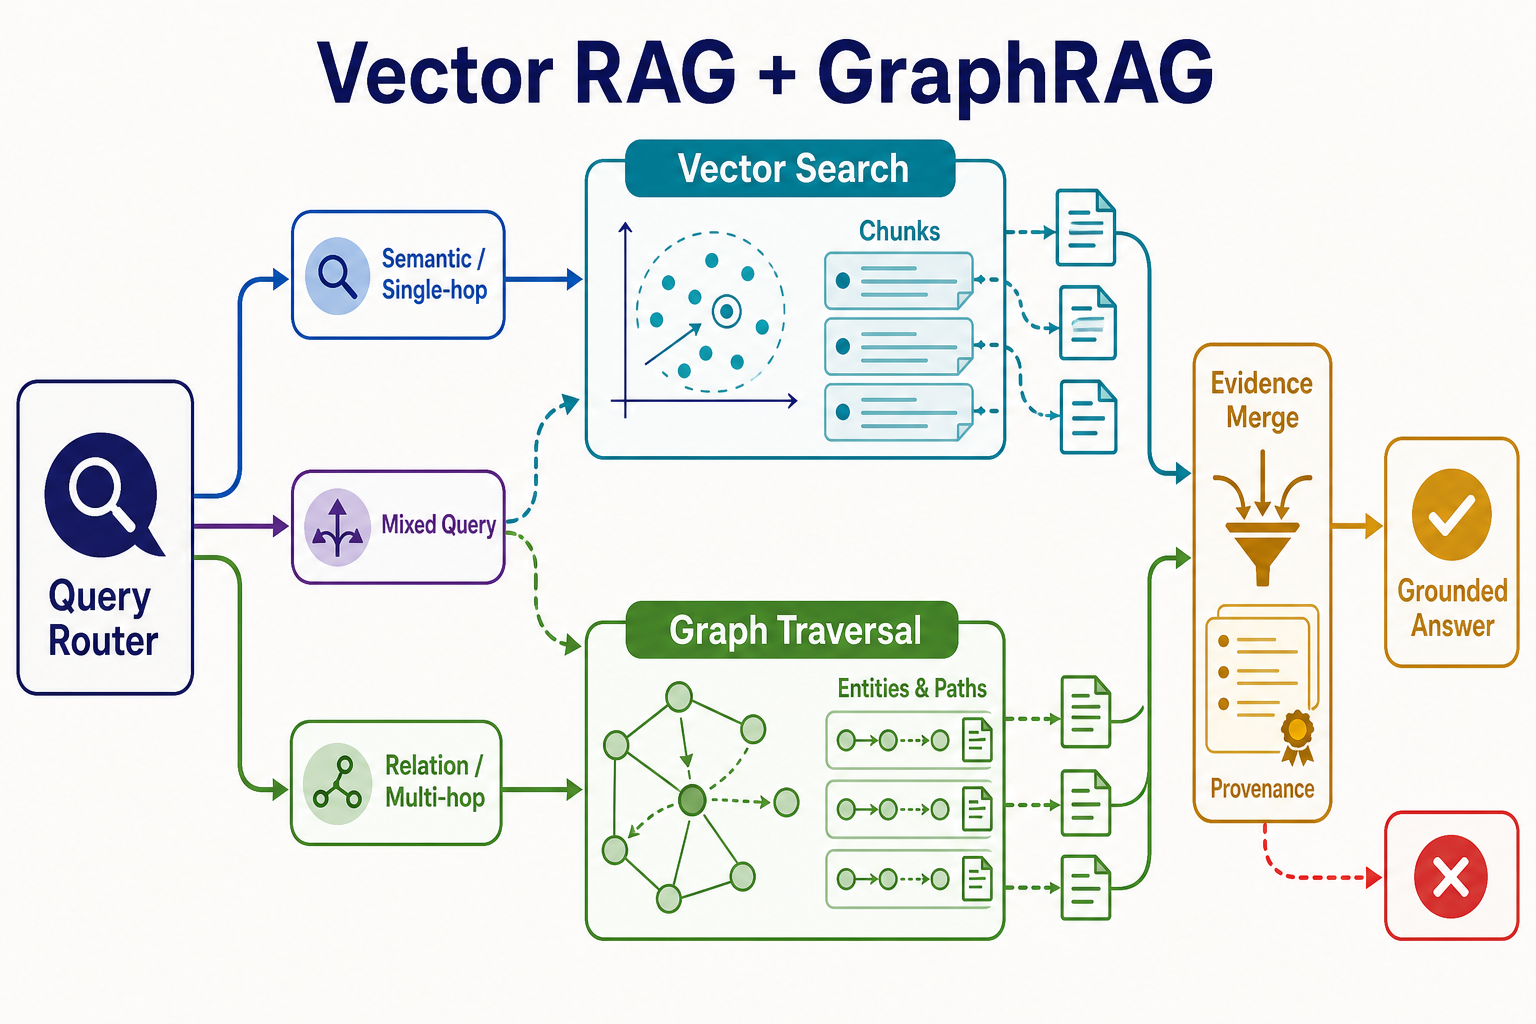
8.1 图检索过程
- 从Query抽取或链接起始实体,如
payment-service、connection_pool; - 根据Intent选择允许的关系类型与最大Hop;
- 在Neo4j中执行受限路径搜索;
- 对路径按长度、边类型、时间、来源质量打分;
- 取路径关联的
chunk_id回到原文; - 与向量和BM25候选融合。
简化路径分数可以写成:
必须限制关系类型、Hop数、候选节点和时间窗口,否则高连接度节点会造成路径爆炸。图中每条由模型抽取的Relation都应保存source_chunk_id、Extractor Version和Confidence,不能脱离原文成为不可追溯事实。
8.2 双索引版本一致性
Milvus和Neo4j之间通常没有跨库事务。使用不可变版本、幂等任务和Manifest:
CREATED
→ MILVUS_READY
→ NEO4J_READY
→ READY
→ switch query alias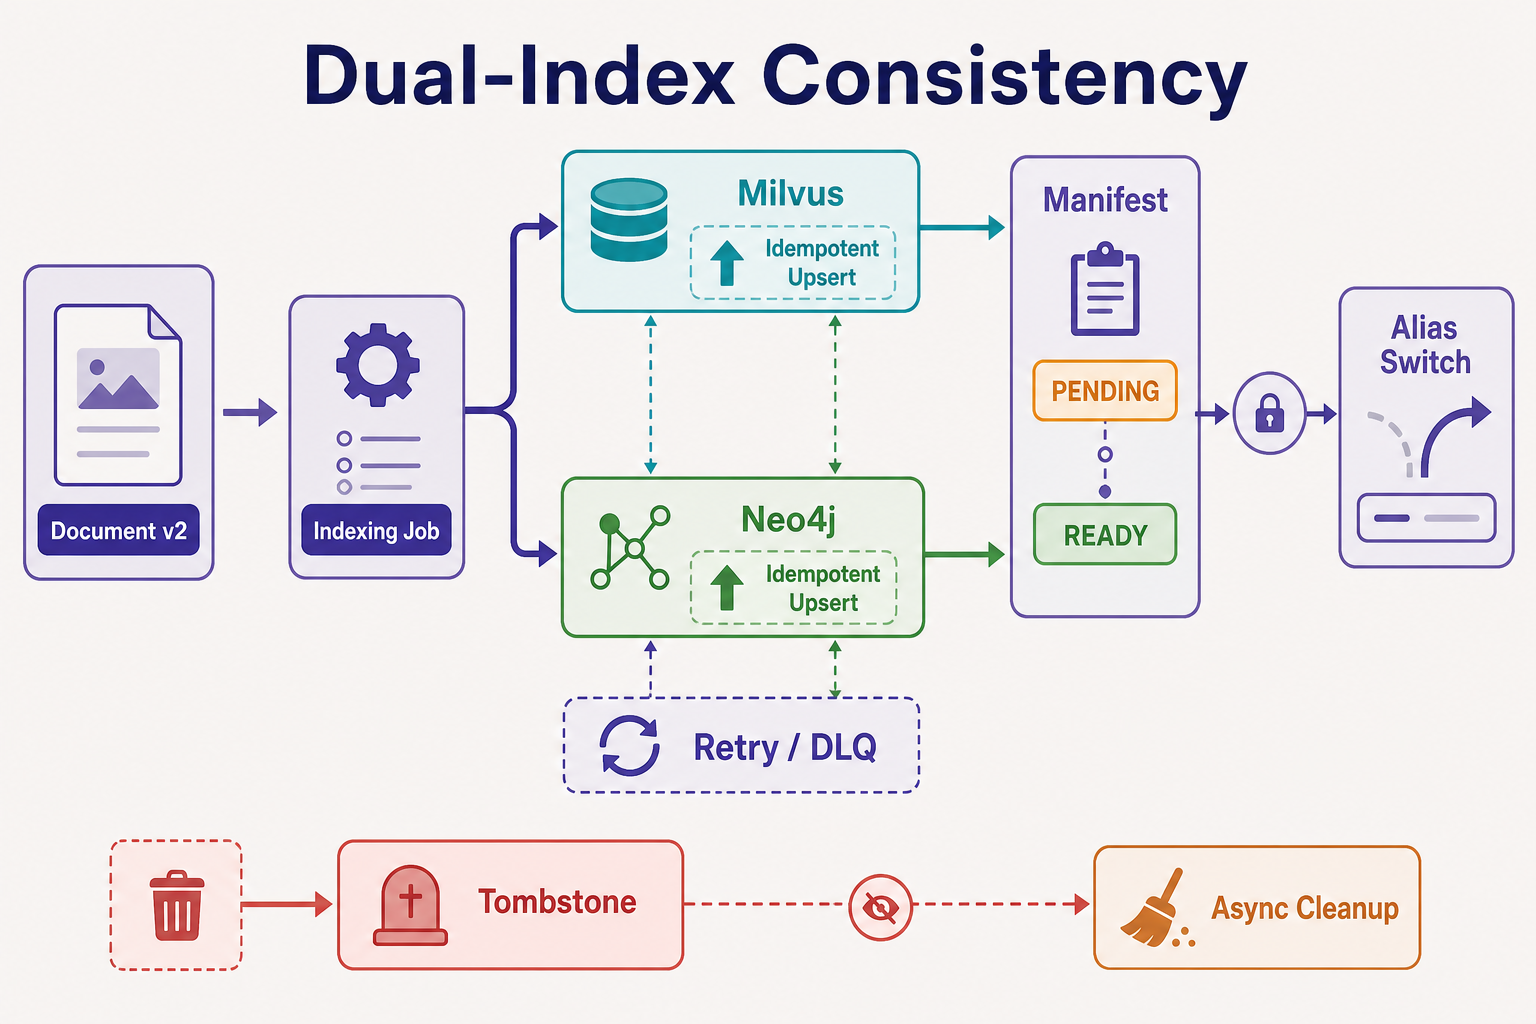
查询只读取READY版本。Job使用doc_id + version_id作为幂等键;失败后重试同一版本。删除先写Tombstone使旧版本不可见,再异步删除Milvus向量和Neo4j节点。物理清理失败不应使已删除内容重新参与查询。
9. Context构造
召回正确不等于模型最终看到了正确证据。Context Builder需要在Token预算B内选择证据。若候选i的Token成本为c_i、价值为v_i,理想形式接近带约束的选择问题:
实际通常使用贪心:先按Rerank Score、来源质量、覆盖的新事实与Token成本计算Priority,再加入父块或相邻块,并在超预算时截断低优先级内容。
还需要处理:
- 同文档重复候选;
- 父子块与相邻块扩展;
- 新旧版本冲突;
- 不同来源之间的事实冲突;
- Citation编号和Chunk映射;
- Prompt Injection隔离;
- Evidence不足时拒答。
盲目增大Top-K会提高Token成本并增加Lost-in-the-Middle。重新召回解决“候选中没有”,Rerank解决“候选中有但顺序不对”,Context Builder解决“正确候选是否被完整送入模型”。
10. 生成、引用与拒答
生成Prompt应明确:只能依据Evidence回答;每个关键Claim附Citation;证据冲突时陈述冲突;证据不足时拒答或请求补充信息。生成后可做Claim级验证:
- 将答案拆成原子Claim;
- 为每个Claim提取Citation;
- 检查Citation是否蕴含该Claim;
- 无支持的Claim删除、改写或触发拒答;
- 检查引用的
version_id与当前响应快照一致。
Faithfulness高只说明答案忠于提供的Context,不保证Context本身正确、最新或足以回答问题。
11. 分层评测
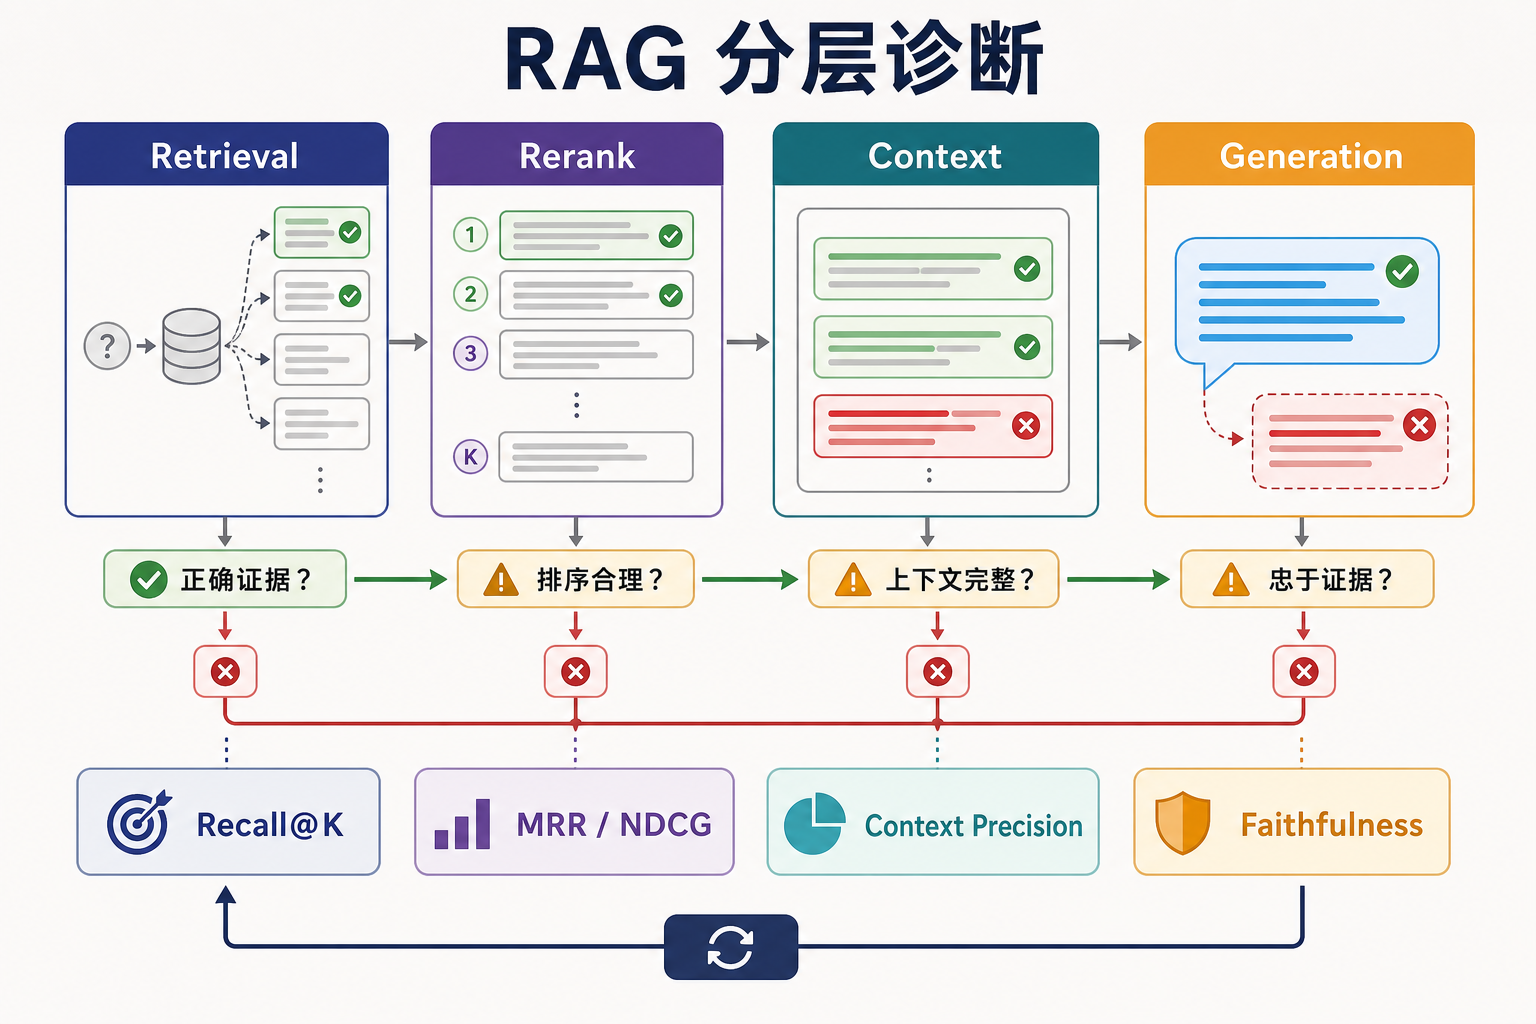
| 阶段 | 问题 | 主要指标 |
|---|---|---|
| Retrieval | Gold Evidence是否进入候选 | Hit Rate、Recall@K |
| Ranking | 正确证据是否靠前 | MRR、MAP、NDCG |
| Context | 最终输入是否相关且完整 | Context Precision、Context Recall、Coverage |
| Generation | 回答是否有依据且答对 | Faithfulness、Citation Precision/Recall、Correctness |
| System | 延迟、成本、安全是否可接受 | P50/P95、Token、拒答、ACL泄漏率 |
评测样本必须同时标Gold Answer和Gold Evidence。指标的完整公式、手算、置信区间与Baseline实验见Agent评测。
12. 项目回答
离线阶段对文档做结构感知Chunk,保存版本、ACL、父子关系和来源;同时建立BM25、Milvus向量索引和Neo4j关系。在线阶段先做权限与版本过滤,BM25召回精确词项,ANN召回语义候选,图检索补充多跳关系;候选按Chunk ID去重,用RRF或校准分数融合,再由Cross-Encoder重排。Context Builder在Token预算内选择证据并保留Citation。Milvus与Neo4j通过Manifest控制版本可见性,不依赖跨库事务。评测按召回、排序、Context和生成分层,Trace保存每路分数、排名和版本。
13. 高频追问
- BM25中
k1和b分别控制什么,中文分词错误会怎样影响结果? - 归一化向量下,Cosine与Inner Product为什么排序等价?
- HNSW的
M、efConstruction、efSearch如何影响Recall、内存与延迟? - IVF的
nlist和nprobe如何选择? - RRF为什么不需要分数校准,又损失了什么信息?
- Cross-Encoder为什么只用于候选重排?
- Graph Retrieval怎样限制路径爆炸并保留来源?
- 双索引只完成一边时,Manifest如何阻止半成品被查询?
- Top-K变大为什么可能让最终答案变差?
- Faithfulness高为什么仍不等于Answer Correctness高?